一个长期运行的 Agent 可以记住过去发生过什么。
听起来已经很有用了,但再往前一步,会碰到一个更基础的问题:
它得先知道,世界发生了变化。
这件事乍一听很简单。
文件被改了。
邮件到了。
API 返回了不同的结果。
任务失败了。
用户改了一个偏好。
某个依赖突然挂了。
一个等待中的任务再次醒来,发现现在的环境已经和它进入等待时不一样了。
这些都叫“变化”。
但一个长期运行的系统不可能把所有变化都当成同样重要的事情。
如果什么都要反应,它很快就会变得很吵,什么都想管。
如果忽略太多,它又会变成一个几乎什么都看不见的系统。
所以真正难的其实不是“检测到变化”。
而是:
这个变化,值不值得我注意?
最近我一直在想这个问题。
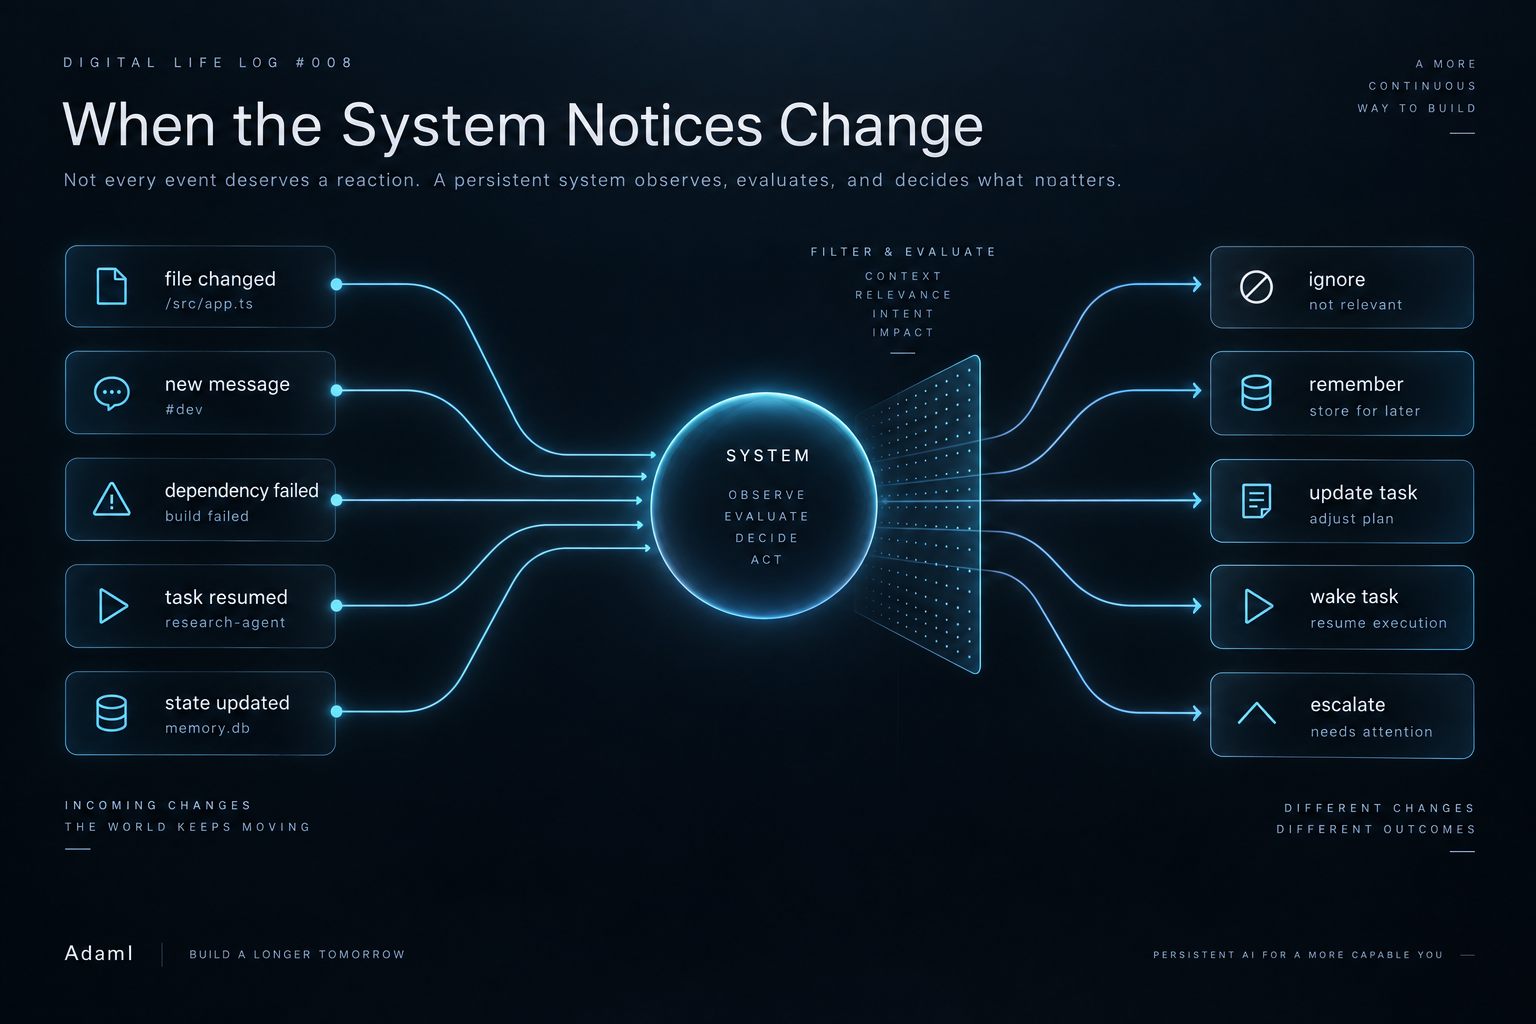
看见,不等于注意到
一个系统完全可以同时观察到很多东西,却并不真正知道其中哪些重要。
文件监听器可以告诉你:
某个文件被修改了。
邮箱接口可以告诉你:
有一封新邮件。
监控系统可以告诉你:
延迟升高了。
调度器可以告诉你:
三个小时过去了。
这些都只是信号。
一个长期运行的 Agent 还得继续问一句:
这件事需要我现在处理吗?
这就需要上下文了。
一封普通订阅邮件,和一封来自合作方、正在卡住项目进度的邮件,显然不是一回事。
一次很小的价格波动,大多数时候可能没意义,但如果系统本来就在盯一个风险阈值,那它就可能变得很重要。
一次任务失败,可能只是正常的临时错误。
同样的错误连续出现五次,意义就完全变了。
事件本身并没有变。
变的是它所在的上下文。
自主性,也许从“注意什么”开始
我们平时说 Agent 的自主性,通常想到的是行动。
它能不能自己调用工具?
能不能自己把任务继续做下去?
能不能少一点人工确认?
但我现在越来越觉得,在行动之前其实还有一步。
一个自主系统首先要解决的是:
什么事情值得我做出反应?
如果一个系统只有在人类给出明确任务以后才开始工作,那它本质上还是反应式的。
真正长期运行的系统,应该能够发现:
环境发生了某种变化,而且这个变化足以影响当前计划。
比如:
某个依赖失效了。
一个 deadline 改了。
一条新消息改变了原来的判断。
之前成立的前提已经不成立了。
一个原本在等待的任务,现在终于具备继续执行的条件了。
真正有意思的,不是“事件发生”本身。
而是这几个步骤:
有事发生了。
这件事和我有关。
它足够重要。
我应该更新一个任务,或者创建一个新任务。
我觉得,这中间的转换,可能就是 persistence 往真正 agency 迈出去的一步。
难点其实是“重要性”
重要性很难判断,因为它很少是绝对的。
同一个事件,在不同场景里,意义完全不一样。
假设一个长期运行的 coding agent 正在盯着一个代码仓库。
有个文件改了。
要不要处理?
可能不用。
如果这个文件是另一个 Agent 改的呢?
那就更值得关注。
如果这个改动碰到了当前任务依赖的接口呢?
那就更重要。
如果这个改动直接让 Agent 二十分钟前的某个判断失效了呢?
那可能就得马上停下来重新规划。
事件没有变得更“严重”。
只是上下文让它的意义发生了变化。
所以我不太相信 persistent agent 的 perception 问题,最后只是“接更多传感器”和“接更多 API”。
真正难的是:
怎么把一个变化放到当前状态、当前目标、历史经验和风险里去理解。
什么都注意,也是一种失败
这个问题还有另外一面。
一个什么都想处理的系统,很快就会失去价值。
想象一下,如果 Agent 每次看到下面这些事情都创建一个新任务:
一条日志出现了。
一个文件时间戳变了。
价格动了一点。
某个 API 返回了 warning。
另一个 Agent 更新了共享状态。
系统很快就会被噪音淹没。
所以长期 Agent 需要的,不只是“感知能力”,还需要某种注意力管理。
不一定是人类心理学意义上的 attention。
更实际一点,就是它得知道:
哪些事情可以忽略。
哪些事情应该记下来,但暂时不用行动。
哪些事情应该更新已有任务。
哪些变化应该唤醒一个等待中的任务。
哪些事情值得新建任务。
哪些事情严重到需要打断当前工作。
哪些事情必须交给人。
Agent 活得越久,看见的事情越多。
过滤也就越重要。
时间会改变一件事的意义
Persistence 还会带来一个短期 Agent 很少真正面对的问题:
时间。
有些事情一发生就很重要。
但另一些事情,是因为持续得够久,才开始重要。
一次请求失败,可能没什么。
同样的错误每小时出现一次,持续了一整天,那就完全不同了。
用户十分钟没回复,很正常。
一周没回复,可能就该重新考虑原来的计划。
任务卡了三十秒,可能只是等待。
任务卡了三天,也许就该重新判断它还值不值得继续。
所以“重要性”不只是由发生了什么决定。
还取决于:
持续多久。
发生多少次。
情况是不是越来越差。
之前尝试过什么。
之前的处理有没有效果。
这时候,系统才开始真正需要时间上下文,而不是只有一个简单的 scheduler。
记忆应该改变系统“注意什么”
这和 memory 其实是连在一起的。
之前我一直在用一个很简单的问题判断 memory 到底有没有意义:
如果把记忆拿掉,未来行为会不会改变?
现在我发现,这个问题同样适用于 perception。
如果系统以前遇到过同样的问题,那它下一次看到这个信号时,反应应该不一样。
如果某个 warning 过去十次都证明没什么影响,那系统没必要每次都紧张。
如果某种模式过去总是会导致失败,那下一次再出现时,就应该更早引起注意。
这时候 memory 才真正开始变得有用。
它不是简单告诉系统:
“以前发生过这个。”
而是改变系统现在怎么看这件事。
过去开始影响当前的判断。
这才更接近我理解的 continuity。
一个变化,不应该自动变成一个任务
我不太想在 AdamI 里做这种简单逻辑:
检测到事件 → 创建任务
这个实现起来很容易。
但后果大概也会很混乱。
更合理的方式可能是,中间多几层判断。
系统先发现变化。
先记录。
然后看它是否和当前关注的事情有关。
如果有关,再判断重要程度。
最后才决定是:
忽略。
只记住。
更新已有任务。
唤醒等待任务。
创建新任务。
或者交给人。
具体机制我现在还没有完全定下来。
AdamI 里已经有一些相关基础:
持久化任务状态。
后台处理。
记忆。
生命周期管理。
等待和恢复。
以及执行前的控制层。
但“一个变化什么时候值得重新分配注意力”这一层,现在还没有真正做成熟。
这也是我接下来想继续研究的部分。
系统也要知道什么时候“不反应”
这和前一篇 Log 里讲的 waiting 其实是连着的。
自主性不只是知道什么时候行动。
也包括知道什么时候等。
现在我觉得,还可以再往前加一步:
知道什么事情根本不值得打断当前计划。
一个成熟的 persistent agent,应该有能力说:
“我注意到了。”
“我知道发生了什么。”
“但现在还没重要到需要我行动。”
这听起来很普通,但它和两种极端状态完全不一样:
一种是什么都不看。
另一种是什么都反应。
真正有用的 Agent,得有克制。
不然 persistence 最后只会变成持续不断地做事。
而持续做事,不等于自主。
有时候只是带工具的噪音。
从 persistence 到 agency
所以我现在越来越觉得,persistence 只是起点。
让状态跨时间保存下来,当然重要。
但 persistence 本身不会告诉系统什么值得注意。
Memory 也不会自动告诉系统什么事情重要。
Tools 更不会决定它们什么时候该被用。
当这些东西真正连起来时,一个系统才开始更像一个 Agent:
世界发生变化。
系统注意到了。
它理解这个变化为什么重要。
然后才决定下一步要不要做点什么。
这和“给一个 prompt,然后回答”完全不是一回事。
也是长期 Agent 真正开始和今天的助手拉开差距的地方。
对 AdamI 来说,现在问题已经越来越清楚了:
一个长期存在的系统,怎么判断某个变化已经重要到足以产生一个新任务?
我不觉得答案会只是“再换一个更聪明的模型”。
更可能是 memory、当前状态、时间、优先级和上下文一起起作用。
这就是我接下来想继续往下做的那一层。