一个长期运行的 Agent 可以记住过去发生过什么。
这听起来当然是好事。
但只要继续往下想一步,就会发现里面藏着一个很危险的问题:
如果系统记住了一件其实根本没有发生的事,会怎样?
这个问题在 Agent 真正开始做事以后,很快就会出现。
它决定改一个文件。
调用工具。
工具返回 success。
Agent 继续往下走。
过一会儿,它把这件事记成:
文件已经更新。
但它真的更新了吗?
也许写入只完成了一部分。
也许路径错了。
也许刚写完就被另一个进程覆盖了。
也许命令返回 0,但结果本身就是错的。
也许 API 接受了请求,但下游系统根本没有真正应用这个变化。
真正危险的地方,不只是“动作失败了”。
而是:
系统以为自己成功了。
一旦这个判断被写进 memory、task state,或者后续 planning 里,错误就不再只是一次局部失败。
它会变成系统接下来理解世界的一部分。
最近我一直在想这个问题。
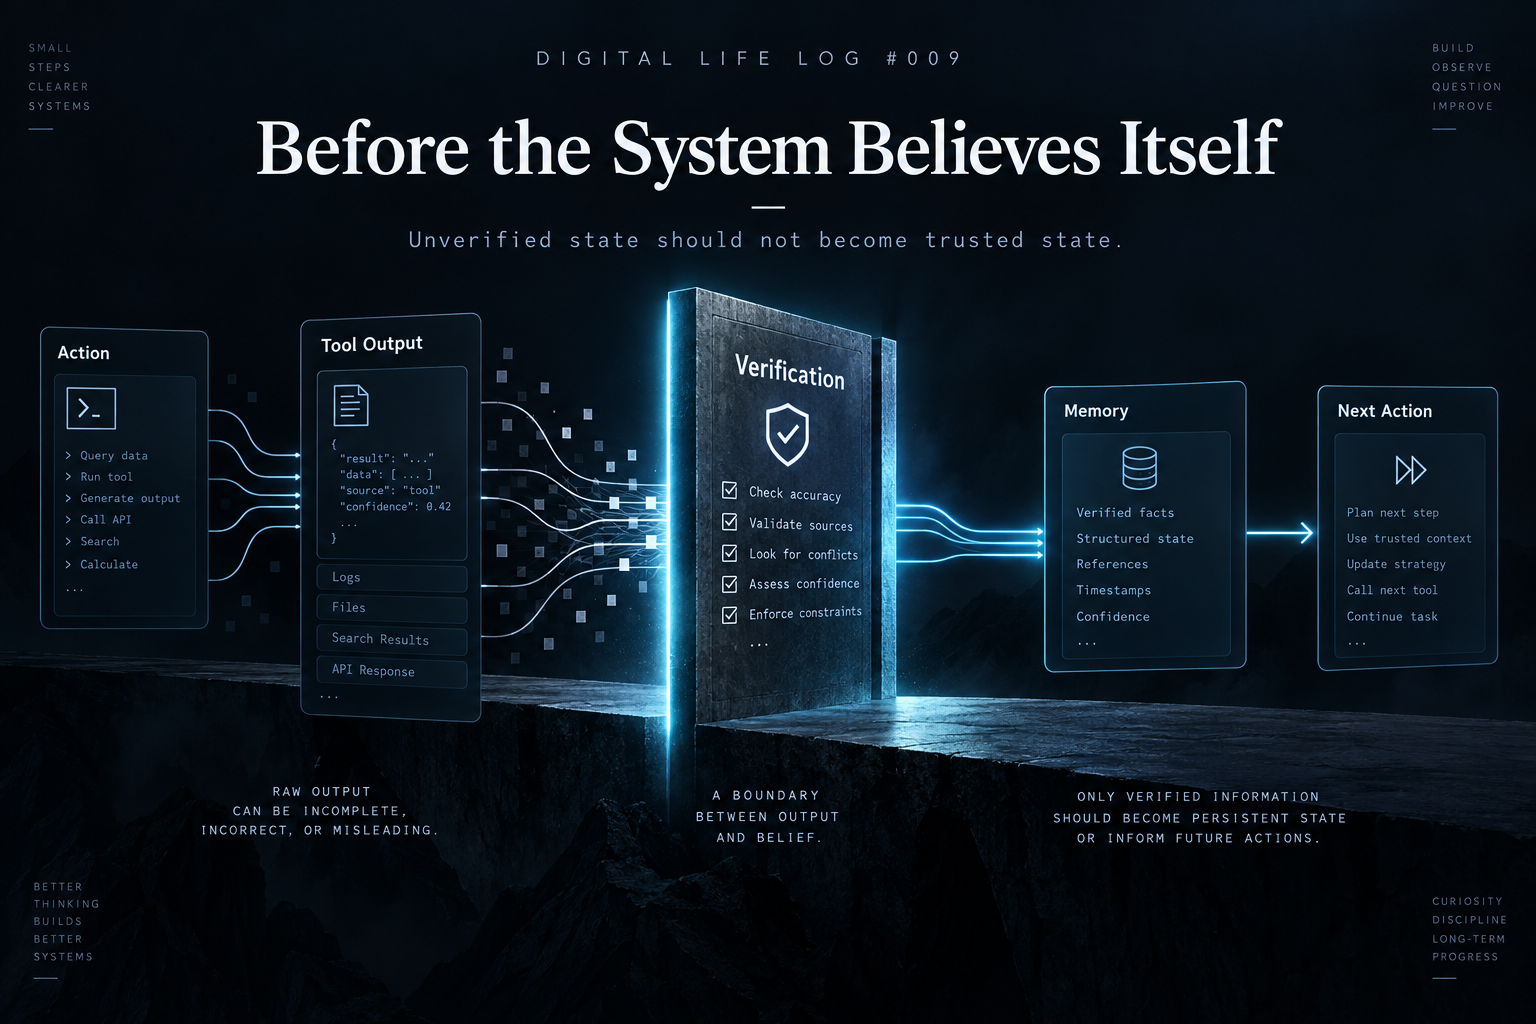
一个 persistent agent,不应该因为某个动作返回了 success,就马上更新自己的内部状态。
它应该先确认:
现实世界,真的变成了它预期的样子吗?
success 其实没有看上去那么可靠
软件系统里,这种问题一直存在。
一个 command 可以正常退出,但生成的文件是错的。
HTTP 返回 200,不代表应用状态一定正确。
数据库写成功,不代表下游 cache 已经同步。
部署脚本跑完了,也不代表新版本真的已经在对外提供服务。
人其实很自然地知道这个区别。
如果我让别人帮我部署一个网站,我真正关心的不是:
部署命令有没有执行完。
我关心的是:
新页面现在是不是已经真的上线了。
这两件事不是一回事。
Agent 也需要学会区分。
现在很多 Agent workflow 其实还是这种结构:
decide → call tool → receive response → continue
对于短任务来说,这通常问题不大。
因为最后还有人在看结果。
但只要系统开始长期运行,这个逻辑就会变得危险。
因为一次动作的结果,很可能成为后面十几个动作的前提。
如果第一步错了,后面所有步骤甚至还能保持“内部逻辑一致”。
系统会继续非常自信地往下走。
只是整个过程建立在一个错误事实上。
一个很小的 execution error,就这样变成了未来状态的一部分。
执行动作,不等于结果真的发生
我觉得这是做 Agent 时最容易混淆的事情之一。
我们很容易把:
我尝试做了什么
和:
世界真的发生了什么
当成同一件事。
比如 Agent 想创建一个文件。
它调用:
write_file
工具返回:
success
那我们到底证明了什么?
其实只证明了一件事:
这个工具认为自己执行完成了。
但这并没有证明:
- 文件真的存在
- 路径是对的
- 内容是对的
- 格式是有效的
- 下一个步骤真的能用它
- 文件没有马上被别的东西覆盖
几乎所有外部动作都有这个问题。
发送邮件。
真的进了收件人的邮箱吗?
更新一条记录。
应用现在读到的是新值吗?
部署一个服务。
外部流量真的已经打到新版本了吗?
重启一个进程。
它真的恢复健康了吗?
创建一个任务。
真正负责执行它的系统能看到吗?
“我尝试过了”和“现实已经按预期改变”,中间这段距离,就是 verification 要解决的问题。
我现在更想要的是这样一个循环
我越来越希望 AdamI 最后的执行循环是:
Intent → Attempt → Observation → Verification → State Commit
前两步其实大家都很熟悉。
系统先决定它希望发生什么。
然后尝试执行。
但在这之后,它不应该马上把结果写成“事实”。
它应该重新观察环境。
然后把观察到的结果,和预期 postcondition 做比较。
只有真的匹配以后,新的状态才值得被写入 memory 或 task state。
这个额外步骤听起来会让流程变慢。
有时候确实会。
但 Agent 权限越大,这一步就越不能省。
如果系统只是回答一个问题,错误假设可能只会造成一个错误答案。
但如果它要连续运行几个小时、几天,甚至更久,同一个错误假设可能会继续影响:
memory、
planning、
permissions、
retry、
以及后续 task formation。
Persistence 会让错误留下来。
也正因为这样,verification 会变得越来越重要。
verification 不能只是“东西存在了没”
还有一个容易掉进去的坑。
一个很弱的 verifier,其实和没有 verifier 差不了太多。
假设 Agent 创建了一个配置文件。
最简单的检查可能是:
文件存在吗?
存在,就算成功。
但这个检查只证明了 presence。
它没有证明 meaning。
文件可能存在,但内容是错的。
可能格式坏了。
可能引用了错误的 service。
可能破坏了别的 invariant。
所以 verification 真正该检查的,应该是:
这个动作预期造成的结果,到底有没有发生。
有些情况下,检查很简单:
- 文件存在
- 进程在运行
- HTTP endpoint 返回 200
但有些时候需要更强的验证:
- 内容结构是否正确
- API 是否真的返回了新值
- 下游行为有没有发生变化
- tests 是否通过
- 另一个组件能不能正常消费结果
- 原来的 invariants 有没有被破坏
我觉得 Agent system 在这一点上需要越来越明确。
“成功”不是一个统一定义。
每个真正重要的 action,都应该有自己的 postcondition。
Verifier 要检查的是这个 postcondition,而不是某个绿色提示。
系统还得知道,自己到底知道到了哪一步
还有另一类情况。
有些事情,本来就没法立刻完全验证。
比如系统发出一个外部请求,但没办法直接观察最终结果。
API 只确认“我收到请求了”。
真正结果可能还要等几小时。
或者必须等某个人审批。
这种时候,最糟糕的做法就是:
把“不确定”直接记成“成功”。
更合理的做法应该是把状态分开:
attempted
observed
verified
still uncertain
这件事看起来很细,但对 persistent system 很重要。
因为 memory 很容易把很多细节压扁。
如果 task log 里只写:
deployment completed
看起来像彻底完成了。
但真实情况可能只是:
部署命令已经完成,公网 endpoint 还没有验证。
这两件事差很多。
我希望 AdamI 最后能保留这种差别。
一个知道“哪些事情已经验证”的系统当然很有用。
但一个知道:
哪些事情自己其实还没有验证
的系统,会安全得多。
错误记忆,比缺失记忆更危险
AdamI 里 memory 这个问题,我已经想了很久。
最开始的问题是:
怎么让系统记得更多?
现在我越来越觉得,另一个问题可能同样重要:
怎么防止它记住错误的东西?
记忆缺失很麻烦。
系统可能重复工作。
可能忘记上下文。
可能又问一遍同样的问题。
但错误记忆不一样。
错误记忆会让未来的 reasoning 看起来很合理。
只是前提是假的。
想象系统记住:
backup 已经成功。
但其实没有。
或者:
dependency 已经升级。
但线上跑的还是旧版本。
或者:
用户已经批准这个操作。
但根本没有。
或者:
task 已经恢复。
但底层故障还在。
这些不只是普通意义上的 hallucination。
它们是 state corruption。
而 persistent system 最大的问题就是:
这种污染不会随着一次回答结束而消失。
它可能继续存在很久。
所以我现在越来越觉得,memory write 应该比 memory read 更谨慎。
把某件事情写进长期状态,本身就是一种 commitment。
系统应该用 evidence 来换这个 commitment。
verification 本来就应该允许失败
这听起来像废话,但其实会改变系统设计。
一个好的 verifier,不应该只是帮 Agent 证明:
对,我刚才是对的。
它必须真的可以说:
不,这件事没有发生。
或者:
我现在还无法确认。
或者:
实际结果和预期不一样。
然后问题就来了。
接下来怎么办?
有时候 retry。
有时候 re-plan。
有时候 rollback。
有时候 wait。
有时候交给人。
有时候直接把 task 标成 failed。
所以 verification 不是流程最后的一个勾选框。
它应该改变控制流。
这也是为什么我越来越把它看成 autonomy 的一部分,而不是普通 testing。
一个能发现自己执行失败,然后主动改变路线的 Agent,比一个盲目继续的 Agent 更有能力。
但与此同时,它也更受约束。
我觉得这两件事必须一起增长。
Recovery 的前提,是先知道现在到底什么是真的
这也会直接影响 recovery。
如果你都不知道当前哪个 state 是真的,那 recovery 很难做得安全。
比如一个 Agent 连续做了三件事:
A 成功。
B 失败。
C 根本没执行。
如果系统把三件都记成 completed,后面的恢复就会很混乱。
但如果它准确记录:
A verified。
B verification failed。
C not attempted。
那整个 recovery path 就清楚很多。
它可以基于 evidence 去判断:
什么真的变了?
什么已经验证?
什么还不确定?
什么可以回滚?
没有这一层,所谓“恢复”很容易变成:
继续多做几个动作。
那不叫 recovery。
那只是继续增加 uncertainty。
Verification 也应该限制 Authority
这里其实还有 governance 的问题。
Agent 权限越大,verification 就越重要。
如果它只是改一条本地 note,验证弱一点,最多只是麻烦。
但如果它可以:
部署软件、
转移资金、
发送消息、
修改权限、
操作基础设施,
那 weak verification 就会变成真正的风险。
这也是为什么我一直觉得:
Capability 和 Authority 不能自动一起扩张。
模型更强,可以尝试做更多事。
但不代表系统应该更轻易相信每一次执行结果。
Authority 越大,对 observation、verification、reversibility 和 audit 的要求就应该越高。
系统不应该只问:
我能不能做这件事?
还应该在动作开始之前就问:
我做完以后,怎么知道它真的成功了?
这个问题最好在 execution 之前就存在。
最好在执行之前,就先定义怎么验证
这是我接下来很想继续做的一种模式。
不是先执行,最后再临时想:
那我现在怎么检查?
而是动作发生之前,就先定义 expected postcondition。
比如:
Intent:
deploy release 42ab59a
Expected result:
production symlink 指向新的 release
EN public route 返回 200
ZH public route 返回 200
release tree 和 artifact 一致
previous release 仍然保留,可以 rollback
然后才去执行。
执行结束以后,verification 只需要拿现实状态和这些预期做比较。
这会让整个过程清楚很多。
还有一个好处:
如果一开始就定义了成功条件,系统就没那么容易在失败以后偷偷修改“成功”的定义。
这开始有一点 transaction 的感觉。
不完全是数据库 transaction。
但底层思路很像:
在你还不知道现实到底发生了什么之前,不要急着 commit state。
AdamI 现在还没有完整做到这一层
AdamI 里已经有一些基础,可以继续往这个方向走。
有 persistent state。
有 task lifecycle。
有 control boundaries。
有 observability。
有一些动作在继续之前也会做检查。
但我不想把它说成已经有一个成熟 verification layer。
现在还没有。
目前 verification 还是不均匀的。
有些动作很好确认。
有些地方还是太依赖 tool response。
有些 state transition 比较扎实。
有些还不够。
Postcondition、evidence、uncertainty、rollback,以及“什么东西值得写进长期状态”,这些地方都还有很多工作要做。
也正因为这样,我觉得这一层很值得继续做下去。
在系统相信自己之前
一个 Agent 越 persistent,self-confirmation 就越危险。
如果每一次 tool result 都马上被当成 truth,系统最后很可能会慢慢建立出一个世界模型。
问题是:
这个世界模型里,很多事实只是它自己没验证过的假设。
一开始可能没事。
直到某一天问题突然堆起来。
所以我现在越来越想给长期 Agent 加一条更硬的规则:
不要相信 action。相信 evidence。
先尝试。
再观察。
验证结果。
然后才更新 memory、task state 或 future plan。
这个循环当然比:
act → assume success → continue
更慢。
但也更可信。
对于 persistent agents 来说,真正的 trust 可能不是来自:
它有多经常成功。
而是来自:
当它失败的时候,它有多清楚自己其实失败了。
这就是我接下来想继续往下做的这一层。