大多数 AI 系统和时间的关系,其实都很简单。
你问一个问题,模型被唤醒,处理请求,给出答案,然后这次运行就结束了。
也许对话会被保存,也许下一次请求里会带上一部分历史记忆,但底层节奏并没有太大变化:先有人输入,后有 AI 响应。
对于助手来说,这种模式已经很好用了。
但一旦开始认真考虑 Agent,这种模式就越来越不够。
我在做 AdamI 的过程中,很早就碰到了这个问题。如果我希望它成为一个真正具有持续性的系统,光有 memory 是远远不够的。
一个系统可以记得昨天发生了什么,但这并不代表它在今天早上醒来之前做过任何事情。
于是问题就变成了:
当没有人在和 AI 说话时,它应该做什么?
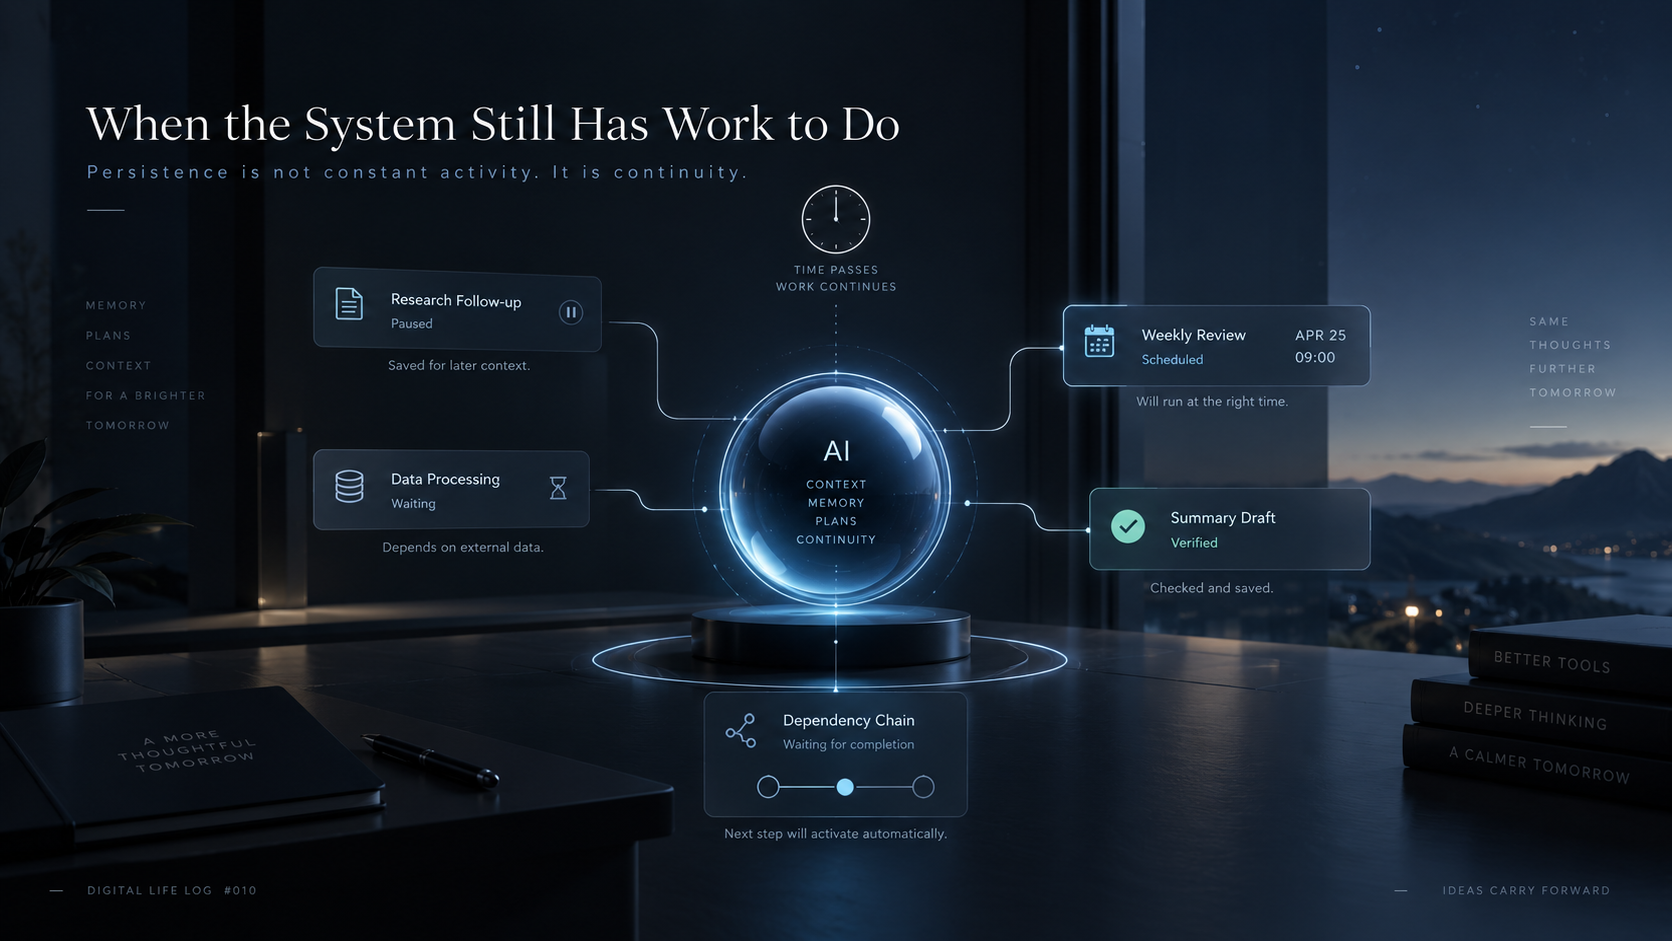
一开始,这个问题听起来并不复杂。
加一个任务队列,让它以后再继续。做一个 scheduler,到了时间再唤醒。技术上这些都不算特别新鲜。
但真正做下去以后,我越来越觉得,这恰好是“助手”和“持续运行的系统”之间开始出现差别的地方。
聊天机器人会等你发 prompt。
一个 persistent system 可以有“还没做完的事”。
这个区别看起来很小,但我觉得它很重要。
最近 AI 行业本身也正在往这个方向走。Coding Agent 已经越来越不像 autocomplete,而更像一个可以拿到任务、读取仓库、修改代码、运行测试、发现问题后继续修正,并且持续工作更长时间的系统。
最近一项 BairesDev 的调查里,42% 的开发者表示,现在至少一半代码已经由 AI 生成,而一年前这个比例只有 12%。但更有意思的不是“AI 写了多少代码”,而是开发者的工作正在往上移:更多时间开始花在 review、debug、security 和 architecture 上。
这说明 Agent 真正有价值的地方,可能不是它能不能在 30 秒里给出一个很聪明的答案。
而是它能不能连续工作几个小时,在必要的时候停下来,记住已经发生过什么,第二天还能继续,并且不需要人每次都重新把整个上下文拼回来。
这其实就是我想让 AdamI 解决的问题之一。
Kernel 是让我开始重新思考这件事的核心模块。
刚开始做 AdamI 的时候,我很自然地把模型放在系统中心。
模型会推理,所以模型就是智能。
模型是智能,那么整个系统自然就围着模型转。
但做得越久,我越觉得这个理解不太对。
一次 model call 是临时的。
它开始,推理一会儿,输出结果,然后结束。
真正需要持续存在的是系统本身。
所以我后来越来越倾向于把模型理解成 cognition,而把 Kernel 理解成 continuity。
模型负责决定“现在应该怎么想”。
Kernel 要负责保证:这次思考结束之后,系统仍然知道自己还有什么事情没做完。
任务系统会让这个区别变得非常具体。
比如 AdamI 上午十点半开始处理一个问题。
它已经收集了一部分信息,也执行了几步操作,但后来发现某个外部依赖暂时不可用。
普通助手在这里其实很好处理。
对话结束。
第二天我再回来,把之前的聊天记录给它,再说一句“继续”。
它也许真的可以继续。
但严格来说,那不是 persistence。
那只是 retrieval。
是我这个人重新把系统启动起来了。
我真正想要的是,任务本身就应该留在系统状态里。
不是只保存一句“昨天还有一个任务没完成”。
而是真正保留这个任务。
为什么会有这个任务。
已经做到哪一步。
现在在等什么。
什么时候应该再次检查。
哪些结果已经验证。
哪里失败了。
如果系统第二天醒来以后发现外部环境已经变化,它应该怎么重新判断。
AdamI 现在已经有一些这方面的基础:persistent task storage、background processes、lifecycle mechanisms,以及跨 model call 保持任务状态的能力。
但我不想把它说得比实际成熟度更高。
AdamI 现在不会每天早上自动醒来,然后给自己安排一套“有意义的人生计划”。
它还没有成熟的 intrinsic drives。
也没有一个稳定可靠的机制,可以把所有观察到的东西自动变成自生成目标。
这些都还是研究问题。
现在真正已经开始成形的,是更基础的一层:
当前这次推理结束,不应该等于系统忘记还有事情没做完。
这一点一旦成立,整个架构就会开始变化。
因为任务可以持续存在之后,“时间”就真正进入了系统。
一个任务可以太早。
可以过期。
可以依赖另一个任务。
可以变得不再重要。
也可能因为环境变化而变得不应该继续执行。
它可能需要先重新观察一次外部状态。
可能需要人类确认。
也有可能,最正确的动作就是什么都不做。
这一点其实比我一开始想象得更重要。
现在大家谈 autonomous agent,经常会把“自主性”理解成活动量。
Agent 不需要人提醒就会行动。
可以连续执行更多步骤。
需要更少人工监督。
可以整夜工作。
这些当然都很吸引人。
但一个总是在不停做事的系统,不一定更自主。
它也可能只是更难控制。
真正的 persistence 带来的问题其实更复杂:
什么时候应该继续?
什么时候应该等?
什么时候应该放弃?
Background process 也不应该理解成一个无限循环,不停去问模型:
“还有什么事情需要做吗?”
那样既昂贵,又吵,而且很可能不安全。
目标不是让 AI 一直在想。
目标是:
在没有人不断发 prompt 的情况下,连续性仍然存在。
这也是为什么我现在越来越觉得,未来的 persistent agent 可能不会像“一个永远在线的大模型”。
它更可能是一组相对安静的机制,围绕着一段一段短暂的 cognition 工作。
大部分时间,系统根本不需要调用 frontier model。
计时器、任务状态、依赖关系、简单检查、wake-up condition,这些完全可以用更便宜、更确定的方式维护。
直到某件事情真的变化了。
deadline 到了。
文件发生变化。
上一次操作完成了。
某个阈值被触发。
人类提供了新的信息。
这个时候,系统才需要更深的推理。
这也是 AdamI 后来采用 dual-brain architecture 的一个原因。
不是每一个事件都值得昂贵的 cognition。
有些事情可以在本地模型或者确定性逻辑里处理。
有些才值得调用更强的模型。
重点不是让 AI 一整天都在“思考”。
而是让系统知道:
什么时候才真的需要思考。
表面上这只是一个实现细节,但 Agent 一旦开始接触真实系统,这个问题就会变得很重要。
最近前沿实验室也越来越直接地开始讨论安全协调、独立评估和高风险能力的共同治理。
我觉得这很合理,因为 long-running agent 会改变 failure 的形态。
短暂的模型响应可能会错。
Persistent agent 可以一直错下去。
它可能第二天醒来以后,继续基于一个错误状态行动。
可能重复执行一个已经不该重试的操作。
可能在环境已经发生变化以后,继续执行昨天制定的计划。
也可能继续持有一套昨天合理、今天已经不合适的权限。
Persistence 会带来很多有价值的能力。
但它也给错误提供了“继续存在的地方”。
这也是为什么 AdamI 里原本看起来分开的几个模块,现在开始慢慢连在一起。
Memory 很重要,因为过去需要影响未来。
Verification 很重要,因为系统不能把错误版本的过去长期保留下来。
Tasks 很重要,因为未完成的意图需要有地方继续存在。
Kernel 很重要,因为这些东西不能依赖某一次临时的 model context。
Guardian 这一类控制机制也很重要,因为“继续执行一个旧任务”本身仍然是一种 action,就算这一次没有人发新的 prompt。
这也是现在的 AdamI 和最早版本相比,我思路变化最大的地方之一。
最开始,我更在意“这个系统看起来像不像活着”。
所以很自然会想到 biological metaphor、internal drives、continuous processes。
其中有些想法后来确实有价值。
但也有一些机制,看起来很像真的,实际上只是“表现得像”。
现在我没有那么在意系统是不是一直表现得很活跃。
我更在意:
continuity 到底是不是真的。
如果 AdamI 可以安静六个小时,然后在正确的时间醒来,继续正确的任务,带着正确的状态,在正确权限下行动,并且先检查之前的假设是否仍然成立——
对我来说,这比一个持续不断地产生“内部活动”的系统更有意思。
安静并不代表没有 persistence。
很多时候,真正的 persistence 恰恰是:
知道应该怎么等。
当然,还有更难的一步现在还没有解决。
如果任务是我交给 AdamI 的,那很简单。
我创建任务。
系统保存。
以后继续。
真正困难的是:
什么时候 AdamI 应该自己创建一个任务?
如果它观察到一个异常,这个异常应该变成后续工作吗?
如果 memory 里长期反复出现同一个问题,它是不是应该主动安排调查?
一个任务执行过程中暴露出另一个问题,系统是不是应该自动生成 follow-up?
走到这里,persistent tasks 就开始碰到 self-generated goals 了。
这个边界很重要。
我不想用一个很简单的办法去“伪造自主性”——比如让模型不断给自己编事情做,然后把这叫 autonomy。
一个系统生成更多目标,不代表它生成的是更好的目标。
所以我现在更愿意把 task persistence 和 task generation 当成两个不同的问题。
先确保 AdamI 能把一个已经存在的 intention 稳定地带过时间。
然后再去问:
新的 intention 到底应该从哪里来?
这个顺序看起来更慢。
但这个项目已经重做过一次以后,我现在反而越来越能接受慢一点。
看起来很聪明的输出并不难。
真正困难的是,一个机制到了明天还能不能继续成立。
而对于 persistent agent 来说,
明天,才是整个问题的重点。