最近做 AdamI 的时候,我越来越常想到一个问题:
我们平时说一个 Agent “更自主”,很多时候其实是在说——它能不能一直行动。
收到目标。
开始规划。
调用工具。
不断往前推进,直到任务完成。
听起来很合理。
但做 persistent behavior 做得越久,我越觉得,这个定义其实不完整。
有时候,正确的下一步并不是继续做点什么。
而是:
先等一下。
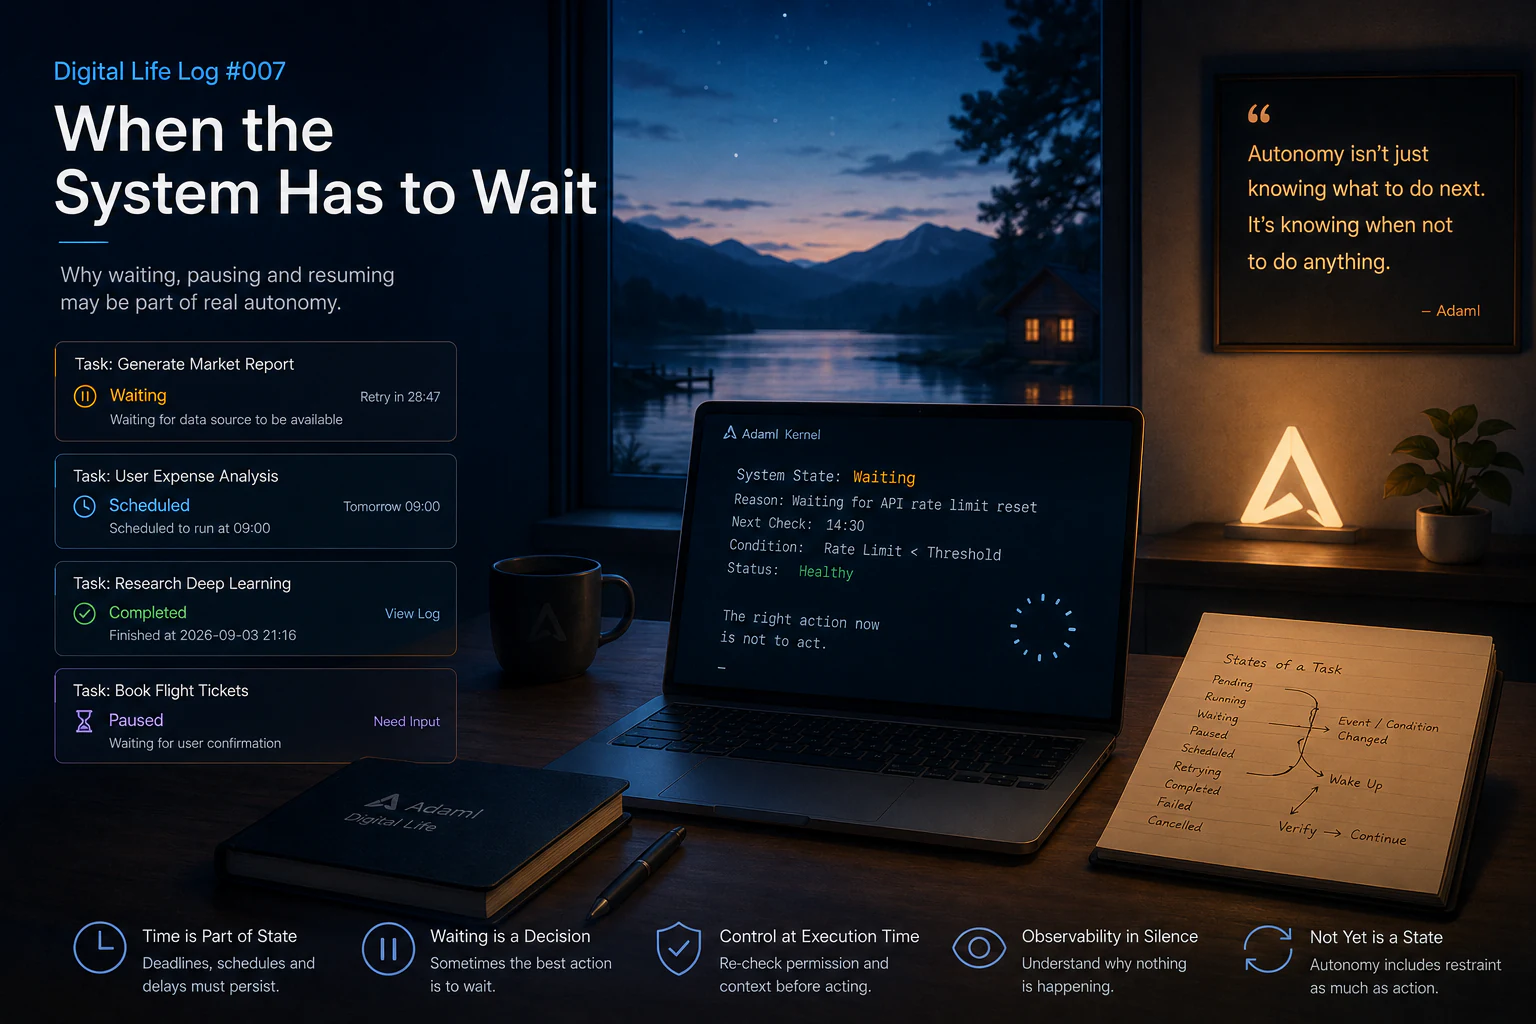
“会行动”其实很容易理解
大多数 Agent Demo 都强调可见的行动。
模型在思考。
工具在被调用。
浏览器在自动操作。
代码在不断写出来。
任务一个接一个完成。
所以我们很容易把 autonomy 理解成:
持续往前走。
对于短任务,这通常没什么问题。
但一个真正长期运行的系统,面对的环境不会一直处于“可以立刻继续”的状态。
API 可能暂时不可用。
权限可能还没批准。
文件可能被占用。
某个步骤需要人工确认。
依赖项可能还没准备好。
有些任务甚至只有在外部条件发生变化以后,才有继续执行的意义。
如果系统永远只会问:
我下一步还能做什么?
那它很容易为了“继续行动”而做出本来不应该做的事情。
“什么都不做”也可以是一个有效决策
听起来很简单,但我觉得这件事其实没那么简单。
一个系统如果会行动,却不会主动选择“不行动”,那它的 autonomy 可能少了一块很重要的东西。
比如,一个 Agent 发现某个依赖暂时不可用。
它可以:
- 立刻 retry
- 找 workaround
- 修改任务
- 请求帮助
- 等待
这些都 technically possible。
但它们并不一定同样合理。
有时候马上 retry,只是在浪费 token 和 API call。
有时候 workaround 会制造更多临时 state,后面还要回来清理。
有时候每隔几十秒就去打扰用户,反而比等 10 分钟更差。
有时候最好的决策真的就是:
现在先不要做任何事。
我越来越觉得,这本身也是 autonomy 的一部分。
Waiting 和 Stopping 不是一回事
问题从这里开始变得更有意思。
如果系统决定等待,它仍然必须保持“自己还是原来的那个任务”。
它需要知道:
- 自己在等什么
- 为什么要等
- 从什么时候开始等
- 什么条件满足以后应该 wake up
- 等待期间条件有没有发生变化
- 恢复以后应该从哪里继续
否则所谓的“等待”,其实只是另一种 forgetting。
一个 task 暂停两个小时以后重新恢复,不应该像一个全新的 task 一样重新开始。
系统需要保留足够的 state,让它回到正确的位置。
所以 waiting 本质上也是一个 persistence 问题。
Task 不能只有 Running 和 Finished
我以前对 task state 的理解其实太简单了。
一个任务大概就是:
- pending
- running
- done
- failed
但真正的 long-running work 显然比这个复杂得多。
一个 task 可能处于:
- waiting for external event
- waiting for permission
- blocked by another task
- paused deliberately
- scheduled for later
- retrying after delay
- cancelled
- timed out
- waiting for human input
这些状态不是简单的标签。
它们会直接决定系统下一步应该怎么行为。
Waiting for permission 的 task,不应该被当成 failed。
明天再执行的 task,也不应该被当成 crashed。
如果是用户主动 pause 的任务,也不能因为 Agent 看到“目标还没完成”就自己重新启动。
这些差异最后都会影响行为。
Retry 是最容易做错的地方之一
Retry 是一个很典型的例子。
最简单的逻辑是:
失败了,再试一次。
然后:
又失败了,再试一次。
看起来很 persistent。
但其实可能只是机械重复。
如果失败条件根本没有发生变化,那继续做同一件事,只是在烧算力。
一个更合理的系统至少应该考虑:
- retry limit
- backoff
- failure 是不是 transient
- environment 有没有变化
- 是否值得换一种 strategy
- 是否应该 escalate
这时候,“时间”就开始进入 reasoning 了。
问题不再只是:
我应该做什么?
而是:
我什么时候再做?
这是一个完全不同的问题。
Time 本身也是 State 的一部分
Chatbot 大多数时候生活在“对话时间”里。
用户说一句。
模型回一句。
但 persistent system 要面对的是真实时间。
10 秒可能有意义。
10 分钟也可能有意义。
明天当然更有意义。
如果 task 里写的是:
30 分钟后再检查。
那这个状态必须活在当前 reasoning episode 之外。
如果一个 process 在等 deadline,这个 deadline 不能因为程序 restart 就消失。
如果另一个 task 提前改变了外部条件,那原本等待中的 task 也许应该立刻 wake up。
做到这里,问题已经越来越不像 prompt engineering。
而更像 runtime behavior。
这也是我在 AdamI 里不断碰到的东西。
Background Activity 不等于一直在“忙”
我一直觉得 background process 对 persistence 很重要。
但最近我发现,如果把 background activity 理解成“系统应该一直做事”,可能也不太对。
一个好的 background system,大部分时间可能什么都不做。
它可能只是:
- watching
- sleeping
- waiting
- 偶尔检查一下 condition
- 只有条件变化时才 wake up
这仍然是系统行为。
只是它没有那么“戏剧化”。
而且我越来越怀疑,这种低频、条件驱动的行为,可能比 Agent 永远不停地产生 action 更有价值。
Waiting 也会带来 Control 问题
这里还有另外一个问题。
如果 Agent 可以安排自己以后再执行,那未来这个 action 的 authority 从哪里来?
假设系统今天决定:
明天再 retry。
但到了明天:
- 用户意图可能已经变了
- permission 可能过期了
- tool 可能已经不可用
- task 可能已经被 cancel
- environment 可能完全不同
所以,一个 future action 不应该因为“之前计划过”就自动继承 authority。
系统醒来以后,应该重新确认现实。
也应该重新确认权限。
这和我前面写 Guardian 时形成的一个想法是直接连在一起的:
Authority should be evaluated at execution time, not assumed from an old plan.
Plan 可以持久化。
Permission 不一定。
Resume 之前应该先 Verify
这其实也和我最近多 Agent 协作里的 state-first workflow 很像。
一个 task 恢复以后,我不希望系统直接顺着旧 assumption 往下跑。
它应该先检查:
到底发生了什么变化?
比如:
一个 task 因为 external service 不可用而暂停。
两个小时以后它 wake up。
继续之前,至少应该检查:
- service 现在真的恢复了吗?
- task 现在还需要做吗?
- 有没有别的 Agent 已经完成了?
- state 有没有变化?
- permission 还有效吗?
所以流程更应该像:
Wait
→ Wake
→ Inspect
→ Verify
→ Continue
而不是:
Wait
→ Continue blindly
这个区别看起来很小。
但我觉得非常重要。
系统需要知道“为什么在等”
还有一点我越来越觉得必须明确化:
Waiting 不能只是一个模糊状态。
一个 task 最好能说清楚:
Waiting for API availability.
或者:
Waiting for human approval.
或者:
Waiting until 09:00.
或者:
Waiting because retry backoff has not expired.
这个 reason 本身就是 state 的一部分。
它决定什么 event 应该唤醒这个 task。
它也直接关系到 observability。
如果我看到 AdamI 某个任务一直没有动作,我希望我能分清楚它到底是:
- broken
- idle
- blocked
- paused
- intentionally waiting
这几种情况完全不是一回事。
什么都没发生的时候,Observability 反而更重要
这件事很容易被忽略。
当 Agent 在疯狂调用工具时,我们通常有很多东西可以看:
logs。
tool calls。
outputs。
changes。
但 waiting 是安静的。
如果系统打算运行几个小时、几天甚至更久,我仍然希望能知道:
为什么这个 task 现在没有跑?
而不是只能得到一句:
Nothing happened.
更有价值的状态应该像:
Waiting until 14:30 because the previous request hit a rate limit. Retry 2 of 4.
这种状态会让系统更容易被理解。
也更容易被信任。
沉默不再意味着“我不知道发生了什么”。
而是一个可以解释的状态。
不行动,有时候比行动更安全
这也直接连到 control。
一个很强的系统通常总能找到“某种动作”。
但这并不意味着它应该执行。
如果信息不完整。
权限不清楚。
环境看起来不对。
那么最安全的有效行为,很可能就是 defer。
这也是为什么我现在越来越不喜欢那种只强调 initiative 的 autonomy 定义。
主动性当然重要。
但 restraint 同样重要。
一个永远都能“找到办法继续”的 Agent,在 benchmark 里可能很漂亮。
放到真实系统里,也可能很危险。
有时候一个好的自主决策应该是:
我有能力做这件事。
但现在还没有足够理由去做。
所以我等。
Persistent Agent 需要一个 “Not Yet”
我现在觉得,这是描述这个问题最简单的一句话。
一个 persistent agent 不能只有:
- yes
- no
它还需要第三种状态:
not yet
Not yet,因为条件不对。
Not yet,因为权限还没有。
Not yet,因为成本太高。
Not yet,因为另一个 task 优先级更高。
Not yet,因为系统还不确定。
Not yet,因为时间本身就是任务的一部分。
看起来只是多了一个词。
但从架构上看,影响其实很大。
AdamI 现在还没有解决这个问题
这里同样需要把当前状态说清楚。
AdamI 已经有一些和这些问题相关的基础:
- task state
- queues
- lifecycle
- background processing
- persistence
- control
但我不会说 AdamI 现在已经有一套成熟的 temporal decision system。
目前仍然没有完整解决:
- waiting conditions
- scheduling
- backoff
- wake-up triggers
- dynamic priority
- time-aware authority
- long-horizon pause / resume semantics
这些都还是开放的设计问题。
现在的实现,至少让我能够清楚看到这个问题。
但还远远不能说已经解决。
Agent 运行得越久,Waiting 越重要
如果一个 Agent 整个任务只运行 30 秒,那么“不断往前做直到结束”通常没什么问题。
但当 Agent 开始运行几个小时、几天甚至更久以后,waiting 几乎一定会出现。
环境会变。
Permission 会变。
用户会介入。
Dependency 会失败。
成本会不断累积。
新信息会出现。
一个 persistent agent 必须能够经历这些变化,而不是每一次 pause 都等于一次 reset。
所以 waiting 最终其实是 continuity 的一部分。
而 continuity 现在越来越成为我在 AdamI 里最关注的问题之一。
知道什么时候不行动
以前我理解 autonomy,主要是:
系统能不能不需要人一直 prompt,也可以继续做下去。
现在我觉得这个定义还是太窄。
一个真正有用的 autonomous system 应该知道:
- 什么时候 act
- 什么时候 continue
- 什么时候 retry
- 什么时候 ask
- 什么时候 stop
- 什么时候 wait
最后这一项,可能比看起来重要得多。
因为一个只能一直往前走的系统,其实并没有真的在“选择”。
它只是在执行。
所以这次我想留下的原则是:
Autonomy isn’t just knowing what to do next.
It’s knowing when not to do anything.
对于一个 persistent system 来说,waiting 并不代表没有行为。
有时候:
Waiting itself is the behavior.
Digital Life Log #007
Building AdamI — a Digital Life in public.