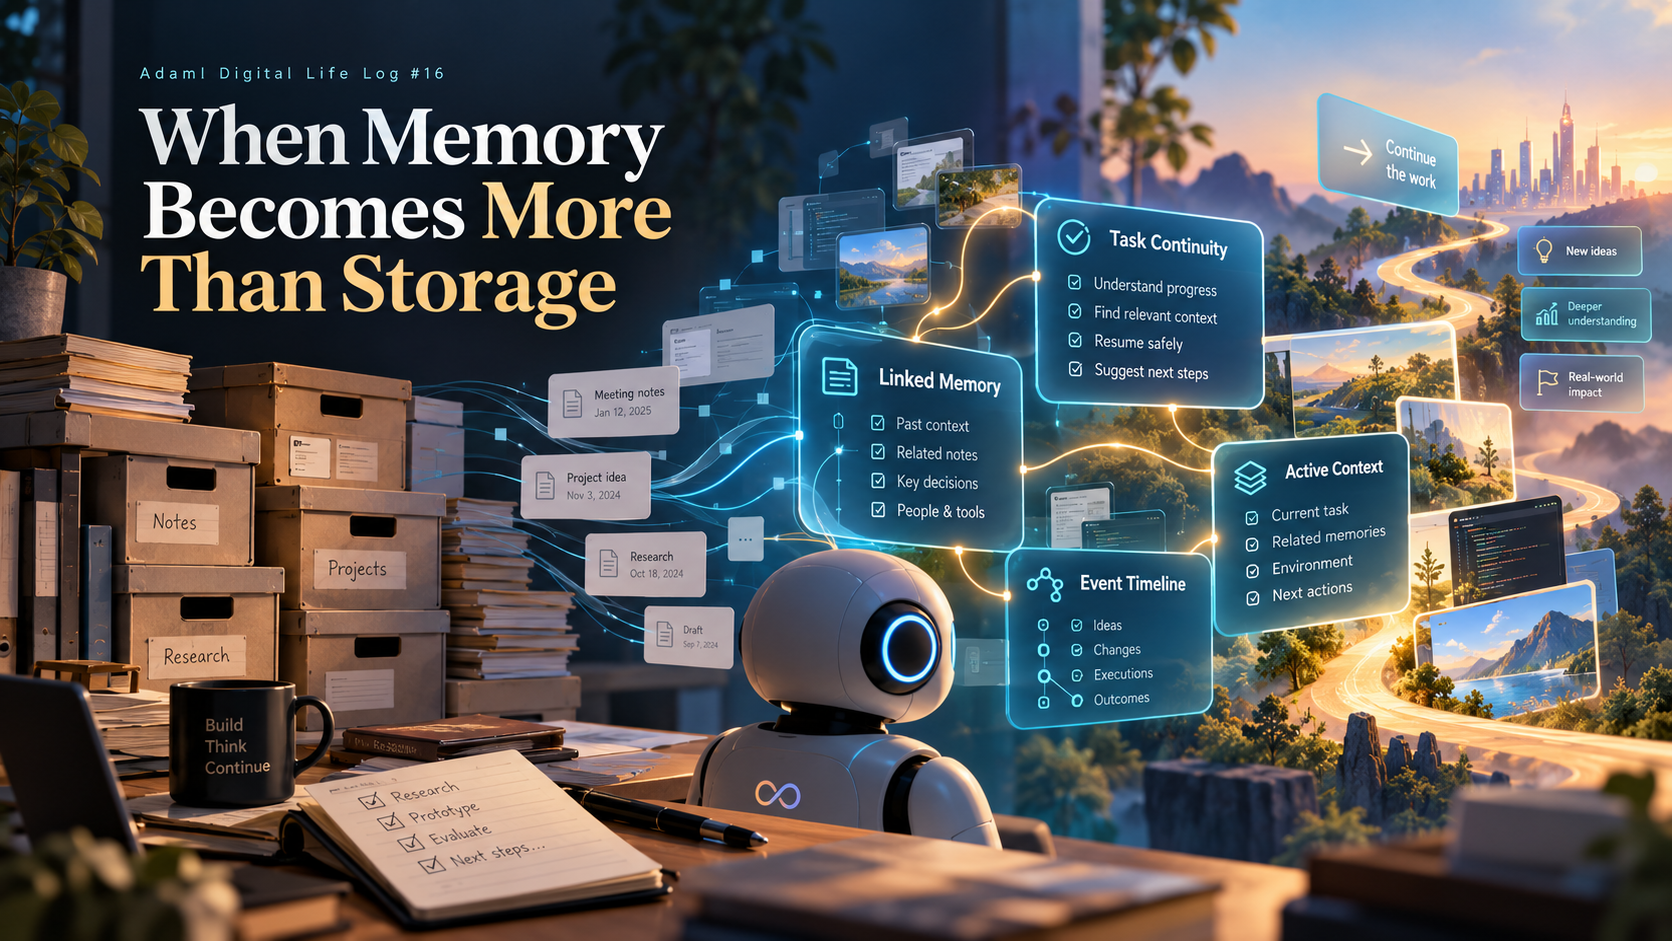
建立记忆系统是一回事,让系统在下一次决策时真正利用过去的经历,则是另一回事。
在开发 AdamI 的过程中,我总是会重新回到记忆这个问题上。
不是因为我们还没有做出任何东西。事实上,AdamI 已经有了记忆系统的几个组成部分:分层记忆、情节记忆、SecondBrain,以及记录模型与工具交互经历的机制。
真正困难的是,如何让这些部分协同工作,并且实际改变系统的行为。
保存信息很容易。
难的是让正确的信息,在未来真正发挥作用。
保存过去,是相对容易的部分
一个 AI 记忆系统的初始形态其实很直接。
发生一段对话,把它保存下来。下一次出现相关问题时,检索出有关内容,再放回模型的上下文。
这当然有用,也很容易让人产生一种感觉:系统记住了。
但当你开始构建一个需要持续处理任务的 Agent,就会发现,仅仅能够检索过去的信息还不够。
假设 AdamI 收到一项任务,执行了几个步骤,随后遇到工具调用失败,任务暂时没有完成。
过了一段时间,用户回来继续这项工作。
一个基础的记忆系统或许能够检索出最初的对话,甚至把之前发生的事情总结得非常清楚。
但这未必足够。
系统还需要知道:任务仍然没有结束,哪些步骤确实完成了,哪里发生了失败,以及从上次执行到现在,外部环境是否已经改变。
否则,它可能把昨天的工作解释得很好,然后再次犯下昨天的错误。
这正是我最近一直在思考的区别:
记住一段对话,不等于能够把一项任务延续下去。
这个问题,其实已经出现在系统的其他地方
随着 AdamI 的生命周期逐渐超出简单的一问一答,这个问题变得越来越明显。
目前,Kernel 已经有了事件驱动的处理路径、持久化任务队列、会话级协调机制,以及分别负责路由、规划和执行的组件。
这样的架构意味着,记忆需要承担的责任,已经不只是帮助模型生成一个更好的回答。
任务可能尚未完成。
一个任务运行时,另一个事件可能到来。
工具调用可能返回错误。
进程可能重新启动。
在这些情况下,系统必须恢复足够的上下文,才能安全地继续工作。它不能把每一次新交互都当成一段全新的对话。
这也直接连接到上一篇日志《当系统学会等待》。
等待之所以有意义,是因为系统能够保留自己正在等待什么。
如果任务暂停以后,暂停的原因也随之消失,那么等待并没有真正解决问题。我们只是把故障推迟到了下一次执行。
一种记忆无法承担所有责任
这也是为什么 AdamI 不只有一个与记忆有关的组件。
SecondBrain 用于整理和保存收集到的笔记与资源。情节记忆关注发生过的事情。分层记忆提供不同层次的上下文保留与检索方式。Experience Sink 则记录模型和工具交互过程中的信息。
它们承担的是不同的责任。
一份保存下来的文档,不等于一个尚未完成的任务。
一个尚未完成的任务,不等于一次过去的经历。
而一次过去的经历,也不应该自动变成未来必须遵循的规则。
最后这一点,比最初想象的更加重要。
假设一个 Agent 曾经调用某个工具失败,随后记录下“这个工具不可靠”的结论。
下一次运行时,是否应该彻底避开这个工具?
未必。
也许那只是一次临时故障。也许输入格式不正确。也许当时缺少权限,而现在权限已经获得批准。
如果一个记忆系统不加区分地把过去发生的每件事都转化成未来的规则,它反而可能让 Agent 变得更不灵活,而不是更有能力。
我们需要保留足够的上下文,理解当时究竟发生了什么,同时避免把每一个过去形成的结论都当成永久正确的事实。
我最在意的是:下一次会有什么不同
对我来说,记忆真正有意思的地方就在这里。
一次经历的价值,不只是我们以后能够把它检索出来。
而是它能够影响下一次决策。
如果任务曾经因为工具超时而失败,那么下一次尝试时,系统应该能够获得这条信息。
如果用户只批准了其中一个步骤,而没有批准接下来的操作,系统应该保留这种区别。
如果先前的某个假设已经被纠正,那么纠正后的信息应该比最初的假设更重要。
如果系统无法确认某项操作是否完成,就不应该把一个不确定的结果保存成确定的事实。
这些都不需要把 Agent 描述成拥有人的经历,或者具有人类意义上的自我。
我们真正需要的是一种更实际的能力:记录发生了什么、我们认为发生了什么,以及我们对这份记录究竟有多大把握。
这里还有一个重要区别:
利用历史信息,不等于编造连续性。
模型可以流畅地讲述自己之前做过哪些工作,但这种叙述本身并不能证明那些工作真的发生过。
我们仍然需要模型叙述之外的执行记录与可验证状态。
记忆应该帮助系统重建当时的情况,而不是代替证据。
AdamI 目前走到了哪里
我希望明确区分:我们正在构建的架构,以及我们已经验证的能力。
AdamI 目前已有记忆相关模块、持久化任务队列、经历采集路径,以及模拟与回放工具。这些都是有价值的基础。
但代码仓库中存在这些组成部分,不等于我们已经证明整个系统能够在长期任务中,稳定地从过去的经历中学习。
接下来还需要验证它们之间的连接。
恢复后的任务,是否真的拿到了继续执行所需的上下文?
我们能否区分已经观察到的工具结果,以及模型对结果作出的解释?
当两条记忆信息互相冲突时,哪一条应该影响下一次行动?
回放能否解释系统为什么作出了某个决定?
当过去的信息已经失效时,系统能否在行动之前识别出来?
相比单纯增加 AdamI 能够保存的信息量,我现在更关心这些问题。
一个越来越大的记忆数据库,很容易成为值得展示的开发成果。
但如果系统仍然不断犯下相同的错误,那么存储容量的增长,其实并不能代表多少实质进步。
记忆也需要边界
还有另一个复杂之处。
Agent 记住的信息越多,我们就越容易让这些信息影响它的所有行为。
但并不是每一条被保存的信息,都应该拥有同样的权威性。
一项用户偏好,不应该自动成为执行其他操作的授权。
过去的一次工具结果,不应该成为当前结果仍然相同的证明。
模型生成的总结,不应该覆盖经过验证的执行记录。
某项任务中的经验,也不应该自动成为适用于所有未来任务的通用规则。
这正是记忆、任务归属以及 Guardian 安全层开始相互交汇的地方。
我们需要在保留有用历史信息的同时,让授权与验证保持独立。
记得昨天某项操作曾经获得许可,不代表今天仍然拥有相同的许可。
对于任何希望长期运行的 Agent 来说,这都是非常重要的一点。
接下来要做什么
下一步,并不是为了增加功能而继续添加更多记忆类型。
而是让已经存在的组件,在实际运行过程中证明自己的价值。
我希望重点验证几个具体场景:任务执行中断、工具调用失败、先前假设被纠正,以及任务恢复时外部状态已经发生变化。
对于每一种情况,我们都应该能够检查:
保存了什么。
恢复了什么。
过去的信息是否按照预期影响了下一次决策。
而如果最终行为发生了改变,我们也应该能够追踪原因。
这才是我希望未来的 AdamI 开发日志记录的进展。
不只是“我们又增加了一个组件”,而是这个组件究竟改变了哪一条真实的执行路径。
现在,我越来越倾向于把记忆理解为:它不只是 Agent 保存过去的地方,更是系统把尚未完成的工作带向未来的一部分。
一个系统可以保存海量信息,却仍然表现得仿佛每天都是它运行的第一天。
我想构建的,是一个能够利用自己的历史,同时又不会被历史束缚的系统。
对 AdamI 来说,这才是下一步真正有意义的进展。
AdamI Digital Life Log —— 一次解决一个工程问题,逐步构建能够持续运行的 AI 系统。