以前我思考 Agent Memory 时,主要把它当成一个 retrieval 问题。
发生了一件事。
系统把它保存下来。
以后遇到类似情况,Memory 系统再把相关内容找出来,放回当前 context。
这个模型当然有用。
但 AdamI 做得越久,我越觉得它并不完整。
因为有些“记忆”已经不只是帮助模型想起过去。
它们会改变系统下一步怎么做。
到了这个时候,我觉得它已经不能再只叫 memory。
它开始变成 state。
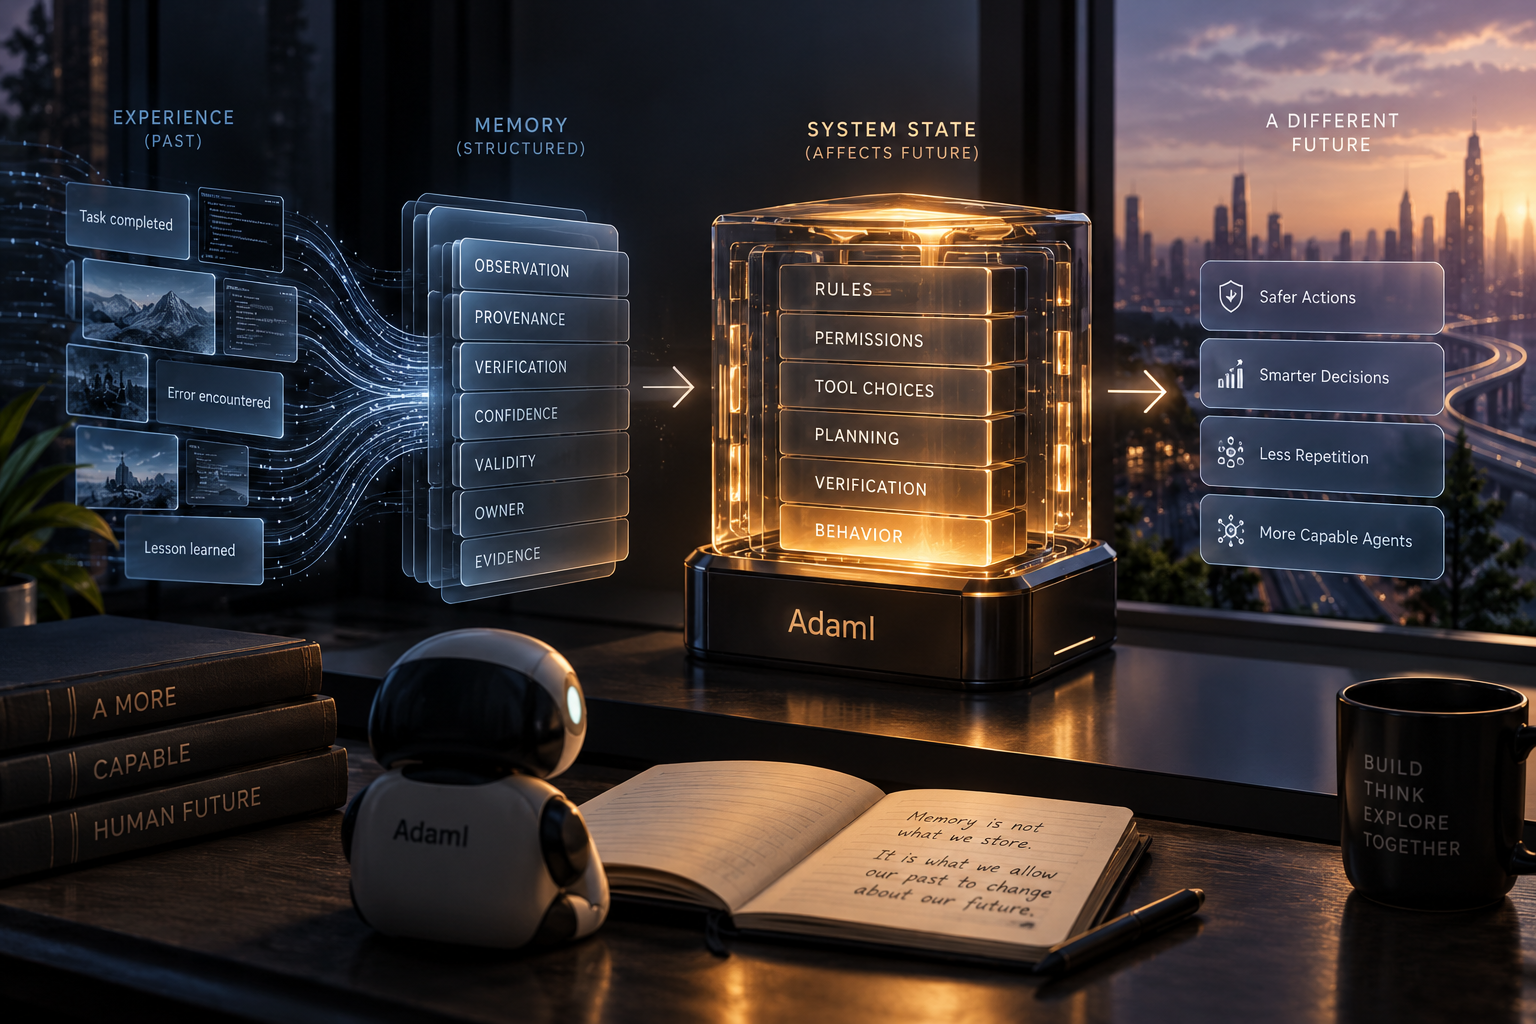
Retrieval 是比较简单的那一层
最简单的 Memory 系统大概是这样的:
发生一次交互,
保存一段文本,
生成 embedding,
以后通过相似度检索把它找回来。
仅仅这一层,就已经可以明显改善 Agent。
它可以减少重复。
可以恢复之前讨论过的内容。
也可以让一些信息跨越一次 model call 继续存在。
但 retrieval memory 本质上还是比较被动的。
信息虽然存在,但系统不一定会使用。
只要它没有被 retrieve,它就不会影响当前行为。
Persistent system 里会出现另一种更麻烦的东西。
比如系统发现:
某次部署失败,是因为少做了一步 verification。
以后它把一条规则保存下来:
每次部署之前必须先做这个验证。
这时候 memory 已经不只是在描述过去。
它开始约束未来。
再比如系统发现某个 credential 只能在一个特定环境中使用。
如果这个限制被长期保存,并开始影响之后的权限判断,那它同样已经不只是“回忆”。
它变成了 state。
一段记忆真正有意义,是因为没有它,未来会不一样
我最近一直反复想到一句话:
A memory matters only when the future would be different without it.
一段记忆之所以真正有意义,是因为如果没有它,系统未来的行为会不一样。
这个定义看起来很简单,但它改变了我对 Memory Architecture 的理解。
如果某个保存下来的信息从来不会改变后续决策,那么它更多只是 archive。
如果它会改变:
task planning
tool selection
permissions
confidence
verification requirements
那它就开始具有 operational meaning。
而 operational memory 的风险和普通 retrieval memory 完全不同。
一个错误的检索结果,可能只影响一次 model call。
一个错误的 state transition,却可能让整个系统连续几天按照错误状态运行。
所以我现在越来越觉得:
Memory write path 可能比 retrieval path 更重要。
Retrieval 解决的是:
我现在应该想起什么?
Memory write 解决的是:
我愿意让什么东西进入系统的未来?
这是两个完全不同的问题。
#011 让这个问题变得无法回避
上一篇 Digital Life Log #011 写的是 uncertainty。
核心非常简单:
如果证据还不完整,那么 uncertainty 不应该随着当前这次 model call 结束而消失。
但只要 uncertainty 可以持续存在,马上就会出现下一个问题:
它到底应该以什么形式保存?
假设一个 Agent 执行了动作。
看到了一部分证据。
但结果仍然不确定。
如果系统最后只保存:
task_completed = true
那么原来的不确定性就彻底消失了。
如果只是保存一句自然语言:
“probably succeeded”
其实也不够。
后面的 Agent retrieve 到这句话以后,可能直接把它理解成事实。
所以系统需要的应该更接近结构化状态:
attempted
observed
verified
uncertain
并且同时保留 evidence。
到了这里,memory 和 state 就已经开始重叠了。
Memory 不再只是:
“以前发生过这件事。”
而变成:
“系统目前相信发生了什么、为什么这样相信,以及这个判断到底有多可靠。”
Persistent Memory 必须知道信息从哪里来
一旦 Memory 会影响未来行为,我觉得 provenance 就无法回避。
这条 Memory 是从哪里来的?
是系统直接观察到的吗?
是模型推理出来的吗?
是另一个 Agent 报告的吗?
是从外部网页复制进来的吗?
是人类明确提供的吗?
有没有独立验证?
如果没有 provenance,时间一长,所有 memory 看起来都会变得一样。
一个不可信网页里取回来的句子,可能和一次经过验证的 deployment result 放在一起。
模型猜测出来的结论,可能和 API 直接返回的数据放在一起。
几个月以前的假设,也可能和刚刚观察到的新证据放在一起。
如果 Runtime 对它们一视同仁,那么 Memory System 最后会变成一个把 uncertainty 全部压平成 certainty 的系统。
这正是我不希望发生的事情。
Persistent system 保存的不能只是 information。
还需要保存 information 的状态。
Memory 应该有生命周期
以前我也低估了 expiration 的重要性。
人类会忘记很多东西。
有时候这种遗忘其实很有价值。
但软件系统经常默认:
Memory 就应该不断累积。
问题是,很多 state 本来就会过期。
Credential 会变化。
API 会变化。
Dependency 会变化。
人的偏好会变化。
项目架构会变化。
任务可能已经失去意义。
以前正确的信息,过一段时间以后可能已经不再正确。
所以 Persistent Agent 不能只问:
我要记住什么?
它还需要问:
这件事我应该相信多久?
所以以后一个 Memory Object 可能天然需要一些信息:
owner
provenance
created_at
last_verified_at
confidence
validity
visibility
revocation
evidence
我不是说 AdamI 里每一条 Memory 都一定需要一个很庞大的 schema。
那样反而会把系统搞得过于复杂。
但至少架构上应该区分两种东西:
一种只是以后“可能有用”。
另一种会直接改变未来行为。
第二种就应该受到更严格的约束。
错误记忆最麻烦的地方,是它可能不会明显失败
Persistent Memory 最危险的地方之一,是错误不一定会马上爆出来。
它可能慢慢变成“正常”。
假设系统保存了一个关于某个服务的错误判断。
下一次任务基于这个判断执行。
结果出现一点偏差。
之后另一个 Agent 又把这个任务的历史结果当成证据。
于是原本一个错误,现在反而拥有了两条“支持记录”。
整个过程中:
没有 crash。
没有明显 error。
Safety filter 也不会触发。
系统只是围绕一个错误假设,逐渐变得越来越内部一致。
这比聊天里 hallucinate 一句话要麻烦得多。
Persistent system 可以围绕错误建立历史。
等到其他模块开始依赖这些历史以后,再修正就会越来越昂贵。
这也是为什么 rollback 很重要。
如果一条 Memory 已经影响了后续 state,我希望知道:
它还能不能被修改?
修改以后,后面基于它产生的状态怎么办?
这已经越来越不像 vector database。
而更像真正的 state management。
Multi-Agent 会让 ownership 变得不可回避
当多个 Agent 共享 Memory 时,这个问题会进一步放大。
谁拥有这条 Memory?
谁可以修改?
一个 Agent 能不能覆盖另一个 Agent 的结论?
一个临时 subagent 有没有资格写 permanent project knowledge?
一个外部 Agent 能不能直接创建所有 Agent 都能看到的状态?
这些已经不是很遥远的问题了。
Coding Agent 现在已经会在 repository、branch、session 和不同工具之间移动。
像 AGENTS.md 这种东西让我觉得很有意思,就是因为它已经隐约表现出一种最简单的 shared procedural memory。
Repo 不再只保存 source code。
它还开始保存:
机器应该如何在这里工作的规则。
但真正困难的问题马上就来了:
谁有资格修改这些规则?
如果每个 Agent 每做完一个任务都可以自动改写 shared rules,系统会很快失控。
如果任何 Agent 都不能修改,它又永远学不会。
真正有价值的架构,大概会存在于这两个极端之间。
Memory write 可能应该是一种 privileged operation
我现在越来越倾向于认为:
Durable memory write 应该被当成某种 privileged operation。
读取 Memory 可以比较便宜,也可以比较宽松。
但如果一条信息会真正改变未来行为,那么写入门槛应该更高。
有些可以自动写。
有些需要 verification。
有些可能需要多个独立 evidence。
有些需要 human approval。
还有一些可能先只能作为 candidate memory 存在。
也就是说,Memory 更像:
propose → verify → commit
而不是:
store everything
这更接近我希望 AdamI 未来演进的方向。
不是每一次 observation 都值得成为长期认知。
不是每一个结果都值得成为 policy。
不是每一个成功 task 都应该自动变成 rule。
系统必须区分:
experience
和
durable knowledge。
AdamI 现在做到哪里
AdamI 目前已经有这个问题需要的几个组成部分。
有 memory layers。
有 persistent task state。
有 ExperienceSink。
有 verification path。
有 Guardian layer。
也有不同 model roles 和 background processes。
但 experience、memory、task state 和 durable belief 之间的边界,现在还没有达到我希望的清晰程度。
目前有些信息会被保存,是因为以后可能有用。
下一步我更想明确的是:
为什么一条信息有资格影响未来?
这可能至少需要把三类东西区分得更清楚:
raw experience
candidate memory
committed state
Raw experience 表示:
发生过这件事。
Candidate memory 表示:
这件事以后可能还重要。
Committed state 表示:
从现在开始,系统允许因为这件事而改变未来行为。
这个最后的转换,我在项目早期其实关注得不够。
接下来要测试什么
接下来我想在 AdamI 里尝试更严格的 Memory write flow。
大概类似:
observation
↓
provenance
↓
trust classification
↓
verification
↓
candidate memory
↓
commit
必要的时候还可以继续:
expire
revise
revoke
rollback
我并不是为了让 Memory 变得复杂而去增加这些东西。
真正的原因是:
Persistence 改变了“犯错”的成本。
Chatbot 可以把错误忘掉。
Persistent system 会把错误留下来。
一个会学习的系统,甚至可能不断加强这个错误。
所以 Memory Architecture 不能只优化:
“以后能不能找回来?”
它还必须保护:
系统未来的完整性。
这才是我现在真正关心的变化。
Memory 不只是系统保存了什么。
Memory 是系统允许自己的过去,对未来产生什么影响。
而一旦它能够改变未来,
它就已经不再只是 Memory。
它已经成为 State。