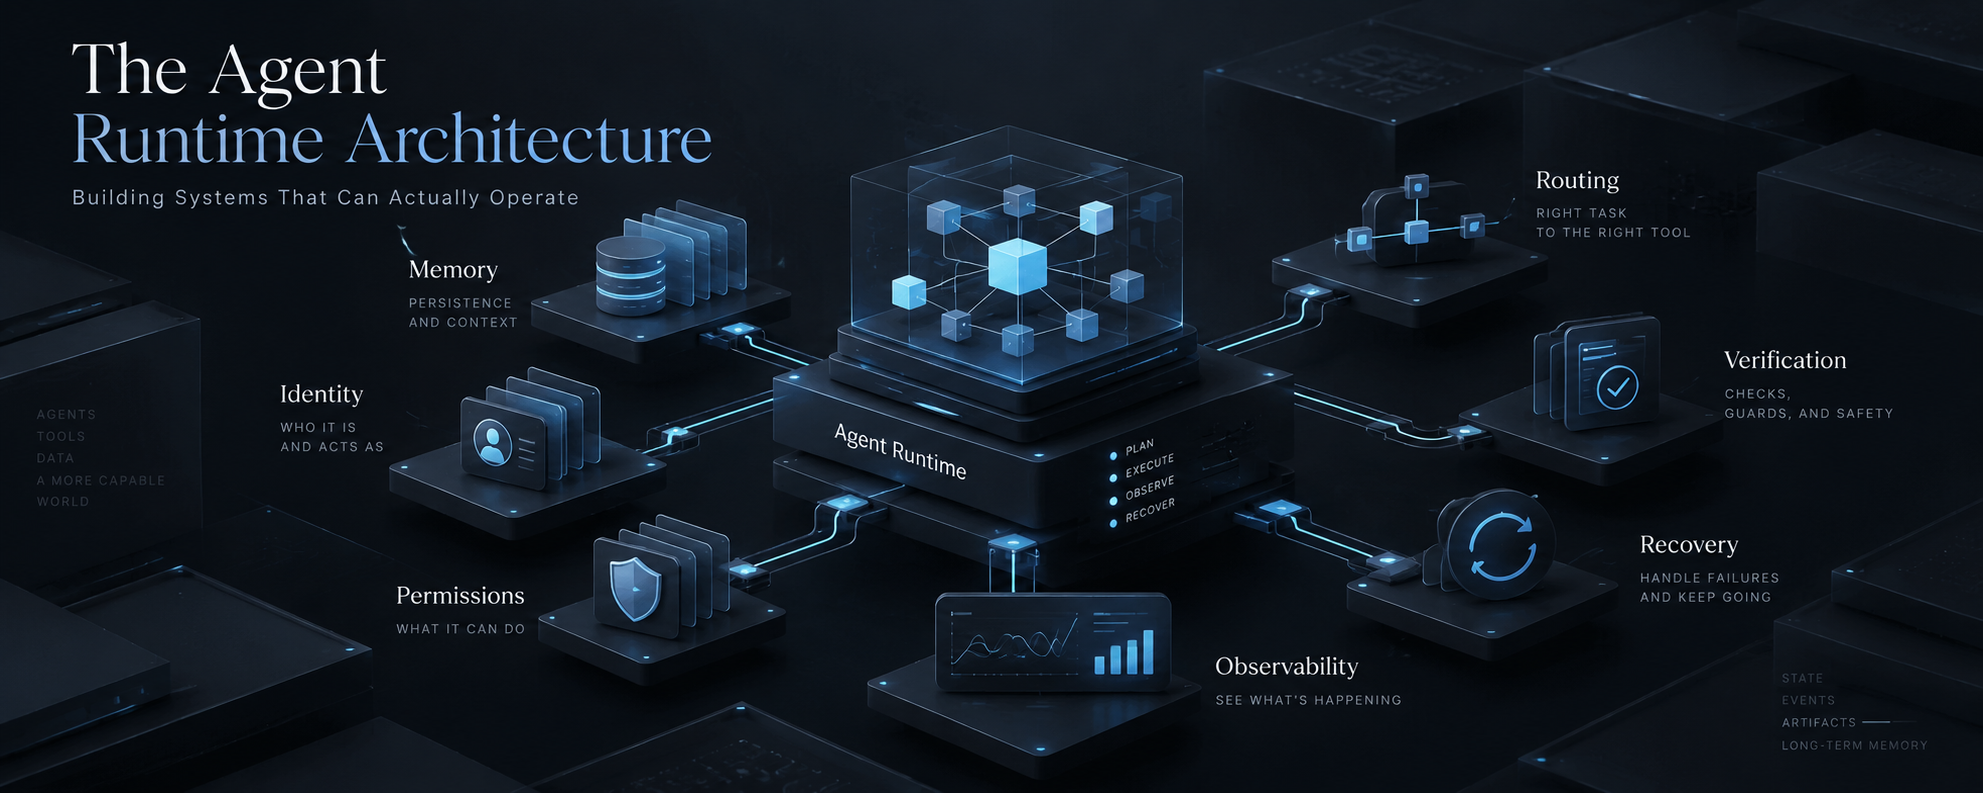
模型负责思考,Runtime 负责让系统持续存在、受控并能够恢复。
刚开始做 AdamI 的时候,我一直以为最难的问题会是“智能”。
模型能不能推理得更好,能不能规划复杂任务,能不能正确调用工具,什么时候用云端大模型,什么时候交给本地模型。
这些问题当然都重要,而且也是最容易被看到的部分。
但做得越久,我越觉得,模型本身可能并不是一个长期运行 Agent 最难的地方。
今天的前沿模型,在一次会话里已经能完成很多事情。它可以读代码、修改文件、分析一个陌生问题、调用工具,甚至在出现一些小错误之后自己调整。
真正麻烦的是:
这一轮模型调用结束以后怎么办?
谁还记得刚才正在做什么?
哪些动作是真的成功了,哪些只是“执行过”?
下一步什么时候继续?
凭证和权限由谁管理?
三小时之后某个后台任务失败了,谁会发现?
是重试,回滚,换一个模型,还是停下来等人确认?
到了这里,一个 Agent 就不再只是“模型 + Prompt + Tools”这么简单了。
它开始需要一个真正的 Runtime。
这也是我这段时间对 Agent 架构看法变化最大的地方。
模型提供的是认知能力。
Runtime 提供的是连续性。
而一旦系统需要连续运行,问题马上就从“模型够不够聪明”,变成了一整套更传统、也更麻烦的软件工程问题。
模型可以判断下一步应该做什么。
但必须有另一个东西,让“下一步”在模型调用结束之后依然存在。
它需要保存当前状态,记住还有哪些事情没完成,在合适的时候重新唤醒模型,也要知道模型不工作的时候系统发生了什么。
这也是为什么 AdamI 里的 Kernel 后来变得越来越重要。
Kernel 本身不负责“聪明”。
它负责的是,让系统在两次智能活动之间没有消失。
这个区别看起来很小,但它会直接改变整个架构。
一个长期运行的 Agent,其实不应该让前沿模型 24 小时不停地“思考”。
绝大多数时间,根本没有必要。
一个任务可能正在等外部服务返回。
文件没有发生变化。
某个进程还在运行。
下一步操作可能必须等用户批准。
这些时候,系统应该继续存在,但不需要不断生成新的推理。
所以我现在更愿意把 persistence 理解成:
持续存在的不是 cognition,而是 state。
而只要有 state,memory 的问题马上就来了。
以前我更多把 memory 当作一个检索问题。
把有用的信息保存下来,需要的时候 embedding search,再塞回 context。
这个思路对普通 chatbot 很有用,但对 persistent agent 来说远远不够。
因为当一段过去的信息真的会改变未来行为之后,它就已经不再只是“可以被搜索出来的内容”。
它开始变成系统状态的一部分。
一个过去的经验,可能改变 Agent 下一次怎么规划。
可能改变它选择哪个工具。
可能改变它对结果有多大把握。
甚至可能改变某个操作到底允不允许执行。
到了这个阶段,memory 已经不是“模型读到的资料”。
它是 Runtime 的一部分。
而这时候 provenance 就变得很重要。
比如 Agent 记住了一条:
“这个项目应该按照某种方式部署。”
那么这条信息到底是从哪里来的?
是一次真实部署验证出来的?
只是某个 Agent 推断的?
来自已经过期的文档?
还是别的 Agent 写进去的?
它有没有被验证过?
多久以后应该失效?
谁可以修改?
能不能撤销?
如果这些问题没有答案,那么 persistent memory 很容易把一次错误慢慢变成长期行为。
而且系统运行得越久,风险越大。
权限也是一样。
让模型拥有一个 tool 很容易。
真正难的是决定:
它什么时候有权使用这个 tool。
如果一个 Agent 可以写代码、访问网络、使用 credentials、改文件、调用外部 API,那么“工具列表”本身已经不够了。
它还需要 authority boundary。
是谁在执行这个动作?
权限是谁给的?
范围有多大?
什么时候过期?
能不能随时撤销?
某些操作是不是必须人工确认?
如果它创建了 sub-agent,权限要不要继承?
这也是为什么我越来越觉得,未来 Agent Safety 很大一部分并不会只存在于模型内部。
模型可以判断“这个动作是否合适”。
但 Runtime 必须保留真正说“不”的能力。
Capability 和 Authority 不能是同一件事。
另一个我最初低估的问题,是 verification。
Agent 非常擅长告诉你:
“完成了。”
但“它说完成了”和“事情真的完成了”是两回事。
一个 tool call 可以返回 success,但外部状态可能根本没达到目标。
命令执行成功,不代表结果正确。
部署脚本结束,不代表新版本真的已经在提供服务。
文件写入成功,也不代表写进去的内容就是想要的。
所以 Runtime 必须区分:
action attempted
和
outcome verified
传统软件工程里,这件事其实很自然。
但当语言模型开始不断解释自己正在做什么时,人很容易被那段“听起来很完整”的叙述骗过去。
所以 AdamI 里我越来越重视 postcondition 和外部 evidence。
能检查的就检查。
能从外部验证的,不要只相信内部返回值。
证据不够的时候,就让 uncertainty 继续保留下去,而不是为了流程好看强行把状态写成 success。
接下来就是 recovery。
我觉得这是 Agent 架构里目前讨论得明显不够多的一层。
大家都很喜欢聊 planning。
但一个计划执行到一半失败以后怎么办,反而经常被忽略。
要不要重试?
最多重试几次?
还用同一个模型吗?
要不要切换到另一个模型重新判断?
需要回滚吗?
是不是应该让另一个 Agent 来检查这次失败?
什么时候必须停下来交给人?
到了这里,orchestration 就已经不只是“给不同模型分配任务”。
它开始变成一种 recovery architecture。
我越来越怀疑,一个真正成熟的 Agent Runtime,大量工作其实不会花在“怎样第一次就成功”,而是在:
失败以后怎样安全地继续。
这也会改变 multi-model 和 multi-agent 的设计。
最直观的做法当然是 specialization。
一个模型负责 planning。
一个负责 coding。
便宜的本地模型处理日常简单任务。
另一个模型负责 security review。
这些都合理。
但如果 routing 只根据“哪个模型最擅长什么”来做,可能还是太简单。
Runtime 最后可能还要考虑:
风险有多大?
成本是多少?
当前证据够不够?
这个 Agent 有没有权限?
任务是不是已经失败过?
结果是否可逆?
有时候最强的模型并不是最合适的模型。
有时候一个便宜模型已经够了,因为任务很简单,而且可以随时撤销。
有时候一个结果太重要,最好让两个独立模型交叉检查。
还有一些时候,正确动作根本不是“继续执行”。
而是等待。
这一点我现在越来越重视。
Autonomy 不只是知道下一步该做什么。
还包括知道:
什么时候什么都不应该做。
只要系统开始持续运行,observability 也会变成基础设施。
如果 AdamI 未来运行几小时、几天,甚至更长时间,我不可能靠一条条看模型对话来知道它现在是什么状态。
我真正需要看到的是:
现在有哪些任务还在运行?
哪些正在等待?
哪里失败了?
哪些结果已经验证?
memory 最近发生了什么变化?
哪些权限被使用过?
哪一个模型做了哪个决定?
现在有哪些状态仍然是不确定的?
传统软件为什么会有 logs、metrics、traces 和 health checks,是有原因的。
Agent 不会让这些东西变得不重要。
恰恰相反。
因为它的行为更不确定,所以 observability 只会更重要。
AdamI 目前其实已经有了这套 Runtime 的一些雏形。
Kernel 负责 continuity。
Orchestrator 负责协调任务。
有不同的 memory layer 和 ExperienceSink。
HybridLLMRouter 负责不同模型角色之间的调度。
还有持久化 task、skills、peripherals、Guardian,以及一些 observability 和 evaluation 机制。
但我不会把它说成已经是一套成熟的 Agent Runtime。
现在还有不少边界并不干净。
Memory 和 task state 有时还混得太近。
Verification 在逐渐加强,但并不是所有关键动作都有足够强的 postcondition。
Recovery 目前仍然比较有限。
随着能力越来越强,permissions 和 ownership 也需要做得更明确。
但也正因为这些问题还没有完全解决,我反而觉得 Runtime 这一层越来越有意思。
现在真正的问题已经不是:
“怎么让模型调用几个工具?”
这件事情正在快速变简单。
更难的问题是:
怎样让一个系统长期运行,同时又不会慢慢失去对自身状态的控制?
目前我更愿意把 Agent Runtime 看成几个东西交汇的地方:
identity、memory、permissions、orchestration、verification、recovery、observability。
它们当然不应该最后写成一个巨大的模块。
但这些模块必须共享一套一致的系统观:
我是谁?
我现在相信什么?
这些信息从哪里来?
我拥有什么权限?
我刚才到底做了什么?
结果有没有被验证?
如果失败了,下一步应该怎么办?
这种一致性,可能比任何一个单独的模块都更重要。
更聪明的模型,可以给系统更好的判断。
Runtime 让这些判断可以延续。
Permissions 给它边界。
Verification 给它证据。
Recovery 让它不会因为一次失败就失控。
Observability 则让人依然能够理解,这个系统现在究竟在做什么。
我最早做 AdamI 的时候,默认模型应该是整个系统的中心。
现在我越来越不确定这一点。
未来模型本身可能反而会成为整个架构里最容易替换的部分之一。
模型会越来越强。
不同模型会擅长不同任务。
价格会变。
本地模型会越来越有用。
新的 provider 也会不断出现。
但无论模型怎么变,Runtime 还是要继续保存系统历史、维持连续性、控制权限、处理失败,并协调所有模型之外的东西。
这一层可能比模型本身更耐久。
模型提供认知。
Runtime 提供连续性。
如果未来我们真的想让 Agent 能够稳定运行几天、几个月,甚至更久,那么最后最难的问题,可能不是让它再聪明一点。
而是让它一直存在,而且始终知道自己正在做什么。