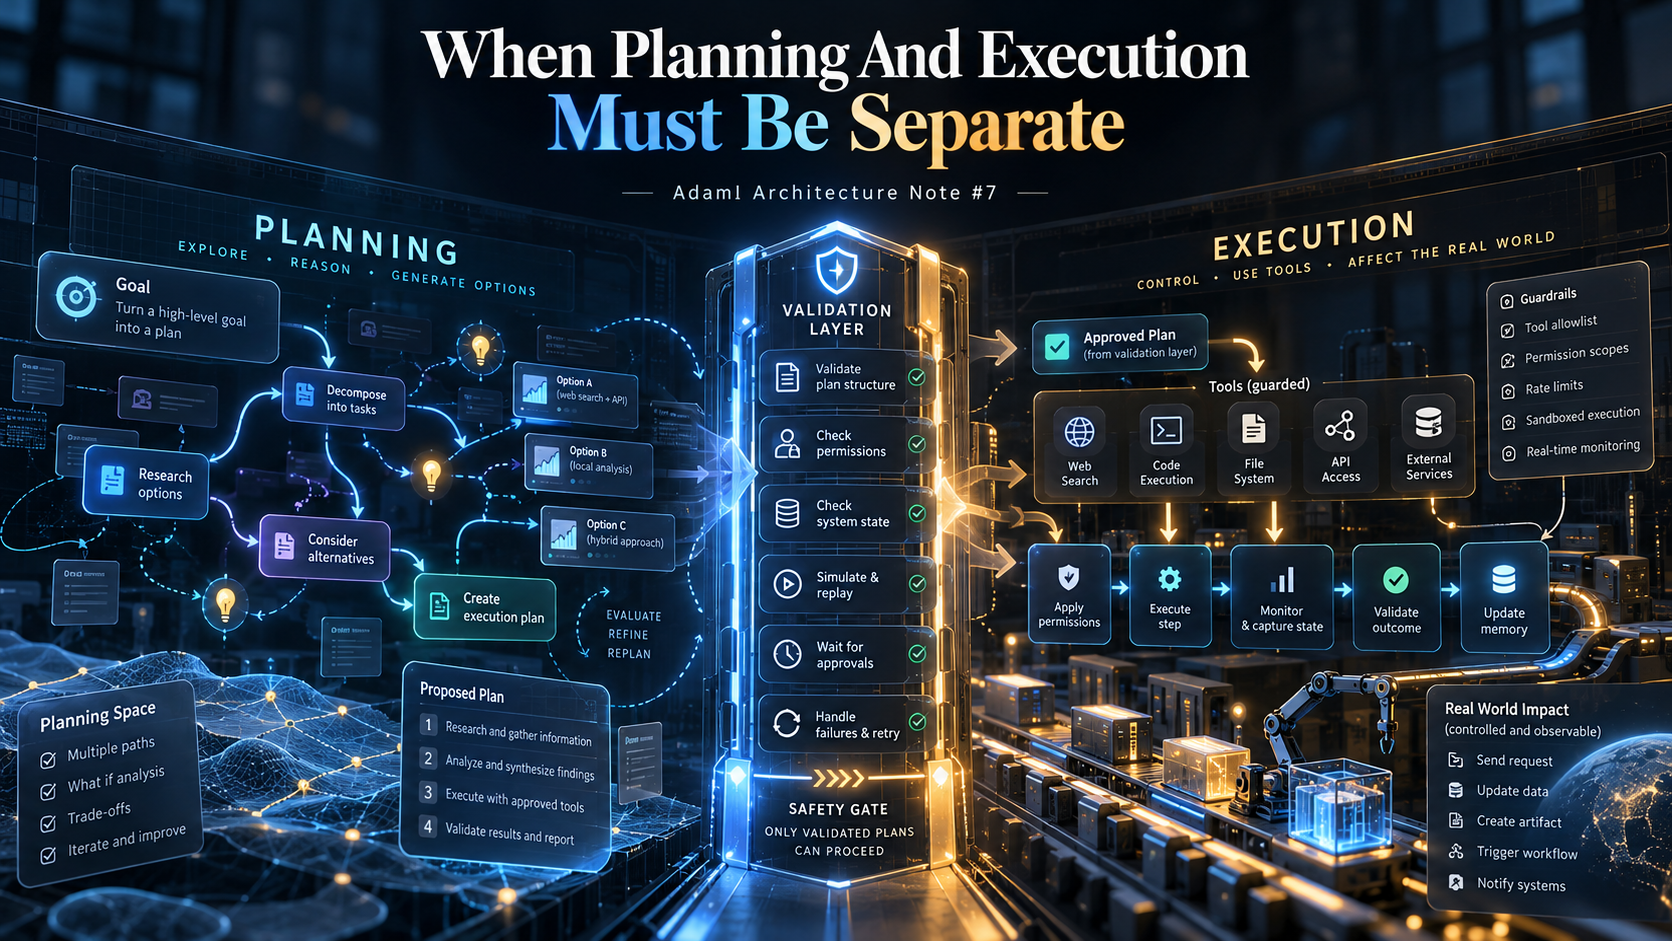
在开发 AdamI 的过程中,有一件事越来越清楚:
“想接下来该做什么”和“真正去做这件事”,不应该被当成同一件事。
一开始,很容易把 Agent 的工作流程想得很简单:
Goal → Model → Action
模型拿到任务,理解目标,判断下一步,然后调用工具执行。
做 demo 的时候,这通常已经够用了。
但一旦 Agent 开始长时间运行,这种结构很快就会让人不安。
问题并不是模型不会规划。
而是:
规划本质上只是一个想法。
执行会真正改变外部世界。
这两者的区别听起来很显然,但当 Agent 开始接触文件、工具、API、任务队列、凭证,以及任何可能产生实际副作用的东西之后,这个区别会带来很多后果。
在开发 AdamI 的过程中,我越来越习惯用一句很简单的话来理解这件事:
A plan is a proposal. Execution is a commitment.
规划只是提议。
执行才是承诺。
它们不应该拥有同样的权限。
这件事之所以重要,是因为模型天生很擅长给出“看起来合理的下一步”。
只要给模型一个目标,再提供足够的上下文,它通常就能生成一套很顺的步骤:
先查看代码仓库。
然后修改文件。
运行测试。
根据报错继续修正。
最后提交结果。
作为“计划”,这当然很有价值。
但这几个步骤实际上处在完全不同的操作环境里。
读取文件,不等于修改文件。
修改文件,不等于执行 Shell 命令。
运行测试,也不等于把代码推送出去。
模型可能会把这些动作理解成一条连续的工作链。
系统不能这样理解。
这正是我现在越来越在意的区别。
模型可以从“下一步应该做什么”这个角度思考。
但 runtime 必须从另一个角度判断:
“下一步到底允许做什么?”
这也是为什么 AdamI 没有把 reasoning、routing、planning 和 execution 全部压进同一个步骤里。
系统里存在不同的部分,分别处理请求应该去哪里、任务应该怎么拆解,以及真正的工作应该怎样执行。
这种分离,并不是为了让架构看起来更复杂。
而是为了给系统留下“中断自己”的空间。
这其实非常重要。
如果规划和执行耦合得太紧,Agent 很容易从:
“我认为下一步应该这么做”
直接滑到:
“那我现在就去做。”
中间几乎没有空间再问:
当前状态还是有效的吗?
这个动作需要额外权限吗?
计划生成之后,有没有什么事情发生变化?
系统现在是不是应该先等待?
工具是否可用?
这个动作是不是已经尝试过?
如果重复执行,会不会产生问题?
这些问题,本来就应该存在于“规划”和“执行”之间。
这也和我最近一直在思考的 persistent agents 有直接关系。
一个短时运行的聊天机器人,可以默认同一轮回复期间,外部世界大体不会发生太多变化。
但一个持续运行的 Agent 不行。
十分钟前生成的计划,可能已经过时。
昨天生成的计划,更应该重新检查。
也许某个文件已经被改过了。
也许另一个任务提前完成了。
也许用户改变了目标。
也许凭证过期了。
也许系统刚刚重启。
也许任务本身仍然有效,但其中某一步已经不再成立。
所以我并不希望 AdamI 把一份生成出来的 plan 当成一段可以一路执行到底的脚本。
计划应该始终可以被修正。
执行应该始终带有条件。
Agent 运行得越久,这一点就越重要。
我喜欢把规划和执行分开的另一个原因,是它让失败更容易被理解。
如果 Agent 做错了一件事,而规划和执行完全混在一起,我们很难判断真正的问题到底发生在哪里。
是 reasoning 错了?
是 routing 错了?
是计划本身没问题,但环境后来变了?
是这个动作本来就不应该被允许?
还是动作本身对,只是参数错了?
这些其实是完全不同的故障类型。
如果架构把它们分开,我们就能拿到更有价值的证据。
我们可以检查模型提出了什么计划。
可以检查执行前的系统状态。
可以检查系统最终允许了什么动作。
也可以检查动作执行之后真正发生了什么。
这比一句简单的:
“Agent failed”
有用得多。
这件事对于 replay 也尤其重要。
我并不希望所谓的 replay 只是重新阅读模型说过什么。
我希望它能够真正重建一条链路:
系统当时知道什么?
模型提出了什么?
runtime 允许了什么?
真正执行了什么?
返回了什么结果?
后续状态发生了什么变化?
如果这些边界足够清楚,replay 就会变成真正有价值的调试工具。
如果这些边界混在一起,replay 最终很容易变成一种“事后讲故事”。
这是完全不同的两件事。
Guardian 这一层也很自然地会进入这个设计。
模型可以提出一个动作。
但这并不意味着模型因此就自动获得执行这个动作的权限。
听起来像是一个很小的架构选择,但我越来越觉得,这可能是自主系统里最重要的选择之一。
模型能力越强,我反而越不愿意让它拥有一条从 reasoning 直接通往外部副作用的直线。
更好的 reasoning,并不会让 control 变得不再重要。
某种程度上,反而会让 control 更重要。
一个能力较弱的系统,通常只能犯有限的错误。
一个能力很强的系统,却可能非常高效地执行一个错误假设。
所以我的目标,并不是阻止模型大胆规划。
相反,我希望它尽可能探索可能性。
真正需要避免的是:
探索能力和执行权限变成同一件事。
这也改变了我对 autonomy 的理解。
我们经常把“自主”理解成:
把人类从流程里拿掉。
但我现在觉得,这个定义并不够好。
一个系统完全可以非常自主,同时仍然拥有很强的内部边界。
它可以自由规划,但行动前重新验证。
它可以持续任务,但在状态不确定的时候停下来。
它可以调用工具,但只在定义好的权限范围内。
它可以从失败中恢复,但不能偷偷把失败重新解释成成功。
这种 autonomy,比单纯让 Agent 一路不停地跑下去更有意思。
AdamI 在这方面还远没有完成。
目前系统里已经存在 routing、planning、workflow execution、task state,以及与安全控制有关的不同组件。
但组件存在,并不意味着这些边界已经被证明是正确的。
接下来真正有价值的工作,是去测试这些“转换点”。
如果一份原本有效的计划,在执行前已经失效,会发生什么?
任务中断后恢复时会发生什么?
如果某个工具在规划阶段可用,但执行阶段不可用,会发生什么?
如果计划里的某一步超出了当前权限范围,会发生什么?
如果系统根本不确定前一个步骤有没有完成,又该怎么办?
这些情况才是真正重要的。
不是因为它们在 demo 里看起来很酷。
而是因为,只要架构太容易相信自己,长期运行的 Agent 就最容易在这些地方出问题。
越是围绕这个问题继续做下去,我越觉得:
把 planning 和 execution 分开,并不只是一个实现细节。
它其实是 control model 的一部分。
模型应该可以大胆地思考。
系统应该谨慎地行动。
这样,我们才有空间把:
validation
permission checks
state checks
waiting
recovery
replay
这些能力插进真正的执行链里。
而不需要让模型自己成为所有事情的最终裁决者。
最后,我还是会回到这句话:
Agent 越自主,就越需要把“它想做什么”和“系统真正允许它做什么”分开。
这也是我希望 AdamI runtime 接下来继续前进的方向。
AdamI Architecture Note #7 —— 一次解决一个工程问题,逐步构建能够持续运行的 AI 系统。