给数字生命增加存储空间,并不会自动带来更好的记忆。数据库回答的是:
“我保存了哪些信息?”
记忆系统要回答的则难得多:
“我的过去有哪些东西此刻仍然重要?”
开始为 AdamI 构建记忆后,这个区别变得非常具体。持续运行的系统会产生大量对话、观察、工具调用、任务结果、失败、决策和内部事件。把这些全都保存下来并不难,难的是判断哪些信息值得留下。
如果每次交互都成为永久记忆,系统最终只会为自己制造噪声:检索越来越困难,冗余不断积累,新旧信息互相争夺注意力,无关经验反复浮现。毫无遗漏地保留一切,反而可能让记忆变差。
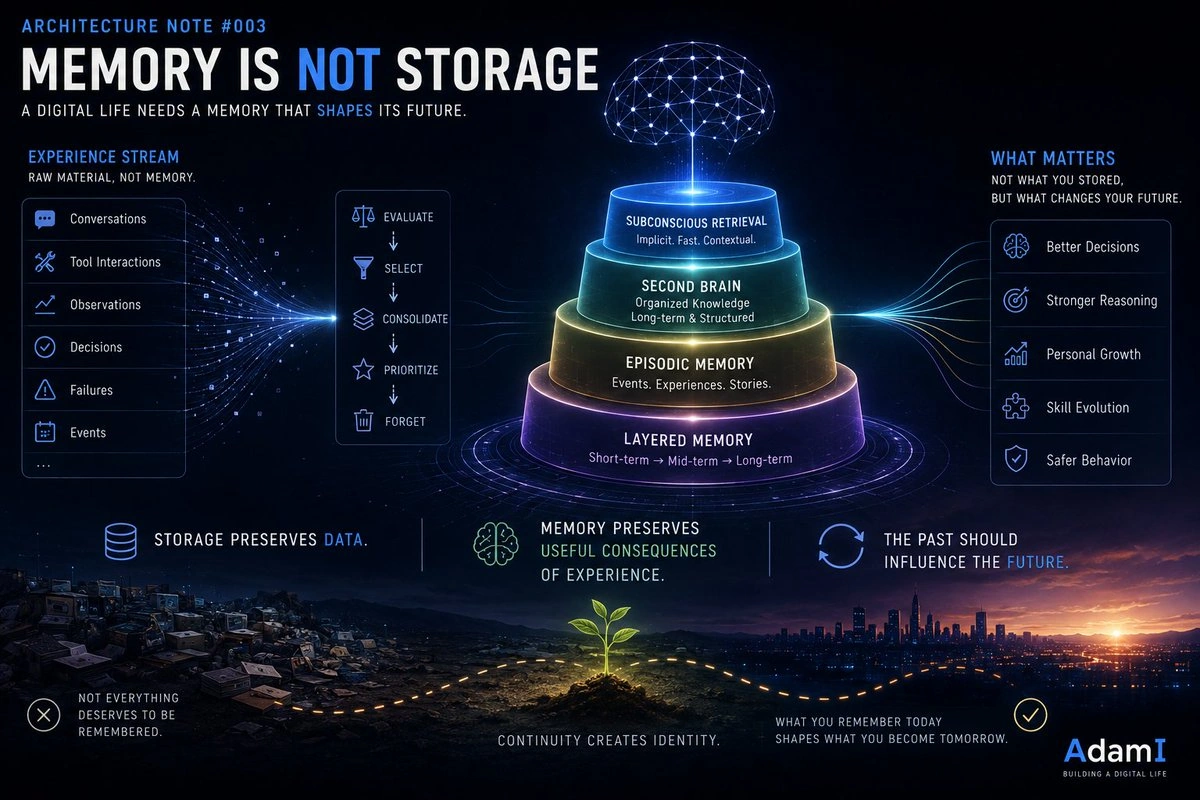
所以我开始把记忆设计成分层系统,而不是一张无所不包的数据库。目前 AdamI 探索的方向包括 Layered Memory,用不同层级保存信息;Episodic Memory,记录经历与事件;Second Brain,组织外部化知识;以及 Subconscious Retrieval,把相关信息带回当前认知过程。
但把模块搭出来还没有解决真正的问题。信息仍然要经历一个生命周期:
概念性记忆生命周期——设计模型,而非经验证的运行时路径
经验
↓
评估
↓
保留 / 整合 / 遗忘
↓
在相关时检索
↓
影响未来认知
其中最关键的是最后一步,因为把一段经验存下来还远远不够。假设系统今天犯了错,事件也被完整记录;可到了明天,它遇到相同情形,依然犯下同样的错误。技术上它“有记忆”,功能上这段记忆却没有起到任何作用。
这让我得到一个更实用的定义:
记忆不在于系统存储了什么。
记忆在于它的过去能够改变它的未来。
如果过去不能改变未来的推理或行为,它更像档案,而不是记忆。
AdamI 也会保存 LLM 与工具交互产生的经验流,但我把它看作记忆的原材料,而不是记忆本身。一次经历发生并被记录下来,不等于它值得长期保留。由此也引出一个起初有些反直觉的结论:遗忘本来就是记忆架构的一部分。
数字生命不应该记住所有事情。它需要让一部分信息逐渐淡出,让一部分保持可检索,也让某些信息随时间变得更重要。否则,所谓记忆就只是不断堆积的数据。
同样,大上下文窗口也没有解决记忆问题。上下文让模型看到“此刻可用的信息”,记忆处理的则是如何跨越时间维持有意义的连续性。两者有关,但不是同一个问题。
我在数字生命日志 #004中写过,记忆让系统拥有过去。从架构角度可以说得更准确一些:存储保留数据,记忆保留经验带来的有用后果;对数字生命而言,这些后果最终必须影响它下一步怎么做。
这套系统还在建设中。AdamI 的记忆架构不是一个完成版的人类记忆模型,我也没有打算照搬人脑。我要探索的是一个更直接的问题:持续存在的人工实体究竟需要怎样的记忆架构?
记忆让数字生命第一次拥有“过去”,但记住过去仍然不够。接下来要问的是,经验能不能改变系统今后能够做什么;技能、学习与演化也正是从这里进入架构。
架构笔记 #003
记忆不等于存储。